LLM 호출에서 AI 에이전트로, 그리고 왜 자바 개발자는 스프링 AI인가
LLM에 질문을 보내고 답을 받는 코드는 이제 몇 줄이면 됩니다. 하지만 기업이 AI에 기대하는 일은 답변 한 번으로 끝나지 않습니다. 목표를 받으면 일을 쪼개고, 사내 시스템을 조회하고, 결과를 보고 다음 행동을 고르는 AI 에이전트가 필요합니다.
그런데 기업의 핵심 시스템은 대부분 자바로 만들어져 있고, AI 라이브러리는 파이썬에서 먼저 나왔습니다. 이 사이트의 첫 글에서는 LLM 호출과 에이전트가 무엇이 다른지, 자바 개발자가 어떤 어려움을 겪었고 스프링 AI가 어떤 답을 내놓았는지 정리합니다. 끝에서는 책의 구성과, 이 사이트가 그 구성을 어떤 설계도 위에서 따라가는지 안내합니다.
LLM 호출과 AI 에이전트의 차이
에이전트의 시대는 여러 흐름이 한꺼번에 성숙하면서 열렸습니다. ChatGPT 이후 GPT-5, 클로드, 라마 같은 LLM이 빠르게 발전했고, AWS, 구글 클라우드, 애저가 생성형 AI 서비스를 넓혔습니다. 새 AI 서비스의 사용자가 급격히 늘고 기업의 도입 요구까지 겹치면서, 텍스트 생성을 넘어 업무를 스스로 처리하는 에이전트를 구현할 토대가 생겼습니다.
챗봇의 LLM은 질문에 답하는 데서 멈춥니다. 같은 LLM에 목표와 툴을 함께 주면 달라집니다. 목표에 이르는 계획을 세우고, 알맞은 툴을 골라 실행하고, 그 결과를 근거로 다음 행동을 정합니다. 주어진 환경에서 이렇게 목표를 향해 스스로 움직이는 지능형 행위자를 AI 에이전트라고 합니다.
책은 "다음 주 하와이 4박 5일 여행 계획을 짜 줘"라는 요청으로 이 흐름을 보여 줍니다.
- 요청을 항공권 조회, 호텔 검색, 활동 추천으로 나눕니다.
- 항공권 조회 툴로 다음 주에 탈 수 있는 항공편을 찾습니다.
- 정해진 항공편 날짜에 맞는 숙소를 호텔 예약 API로 검색합니다.
- 모은 정보를 자연어 일정표로 정리해 사용자에게 제안합니다.
에이전트 하나로도 이 정도는 잘 해냅니다. 문제는 요구가 복잡해질 때입니다. 단일 에이전트는 여행 가이드, 예산 계산, API 호출 같은 역할을 하나의 긴 프롬프트 안에서 모두 맡습니다. 책임이 몰리면 LLM은 중간의 지시를 놓치거나(Lost in the middle) 수많은 툴 가운데 엉뚱한 툴을 고릅니다. 컨텍스트 윈도우의 한계와 역할 충돌이 함께 드러나는 셈입니다. 항공권 가격이 실시간으로 바뀌는데 예산까지 넘친다면, 계산과 예약 사이에서 판단이 흔들리기 쉽습니다.
그래서 역할을 나눈 멀티 에이전트 시스템이 등장했습니다. 사용자와 대화하며 일을 배분하는 오케스트레이터, 항공권과 빈 객실만 찾아 예약하는 예약 전문 에이전트, 날씨와 현지 행사로 동선을 짜는 지역 전문가, 동선과 총비용을 마지막으로 확인하는 리뷰어가 함께 움직이는 식입니다. 소프트웨어 개발에서도 클로드 코드, 오픈클로 같은 에이전트 개발 도구가 나왔고, 코드를 쓰는 에이전트, 오류를 잡는 에이전트, API 문서를 찾아보는 에이전트가 한 팀처럼 맞물려 일합니다.
기업 시스템은 자바 위에, AI 생태계는 파이썬 위에
ChatGPT가 AI의 사업 가능성을 보여 준 뒤, 기업들은 업무 자동화와 고객 경험 개선, 새 서비스를 기대하며 AI 에이전트 도입에 나섰습니다. 걸림돌은 대형 엔터프라이즈 시스템 대부분이 자바 생태계에서 돌아간다는 점이었습니다. DB 연동부터 REST API, 복잡한 업무 규칙까지 모두 수십 년 동안 자바 코드로 쌓아 온 자산입니다.
AI 기술의 중심은 파이썬이었습니다. 텐서플로, 파이토치, 랭체인, 허깅페이스 트랜스포머 같은 주요 라이브러리가 파이썬부터 지원했고, 간결한 문법과 과학 계산 라이브러리 덕분에 실험과 프로토타이핑이 빨랐습니다. 이 불일치 앞에서 자바 개발자는 세 가지 어려움을 겪었습니다.
- 라이브러리: AI 개발에 쓰는 라이브러리 대부분이 파이썬 중심이라 자바에서 활용하기 어려웠습니다.
- 패러다임: 같은 입력이면 같은 결과가 나오는 결정론적 코드와 달리, LLM은 함수 호출 대신 자연어 프롬프트로 주고받고 같은 질문에도 문맥에 따라 다른 답을 냅니다.
- 표준: AI 모델을 기업 시스템에 붙이는 자바 방식의 모범 사례가 부족했습니다.
최근 이 흐름이 바뀌고 있습니다. 자바 네이티브 딥러닝 라이브러리인 Eclipse Deeplearning4j, 파이썬 라이브러리의 발상을 자바로 다시 구현한 LangChain4j가 먼저 가능성을 열었습니다. 2025년 5월 20일 스프링 AI 1.0 GA가 나오면서 순수 자바로 AI 서비스를 만드는 생태계가 자리를 잡았고, 2026년 6월 12일 스프링 AI 2.0 정식 버전과 함께 프레임워크는 본격적인 에이전트 단계로 넘어갔습니다.
스프링 AI의 출발점은 외부 도구의 이식이 아니라 스프링의 개발 방식입니다. 의존성 주입, 자동 구성, 모듈화를 AI 기능에도 똑같이 씁니다. 모델 스타터를 의존성에 추가하고 설정 파일에 연결 정보를 적으면 스프링 부트가 ChatClient.Builder 빈을 만들어 둡니다. 개발자는 이 빌더를 주입받아 build()만 호출합니다. 예제 저장소의 basic-chat이 이 최소 구성입니다.
    @Bean
    public CommandLineRunner chatRunner(ChatClient.Builder chatClientBuilder) {
        return args -> {
            // 1. 질문 준비 (userPrompt 값을 바꿔 실행해 보세요!)
            String userPrompt = "안녕 Spring AI!";
            System.out.println(">>> AI에게 질문: " + userPrompt);

            // 2. AI에게 질문 전송 및 응답 수신
            String response = chatClientBuilder.build()
                    .prompt()
                    .user(userPrompt)
                    .call()
                    .content();

            // 3. 최종 답변 출력
            System.out.println(">>> AI 답변: " + response);
        };
    }
basic-chat은 올라마 스타터를 쓰고 application.yml에 로컬 올라마 주소와 qwen3.5:4b 모델을 지정합니다. 코드는 자동 등록된 ChatClient.Builder로 클라이언트를 만든 뒤 prompt().user(...).call().content()로 질문 하나를 보내고 답을 문자열로 받습니다. 여기에 툴 호출과 어드바이저 체인을 더하면 외부 시스템 연동과 RAG 워크플로도 같은 방식으로 이어집니다. ChatClient의 구조는 ChatModel과 ChatClient 글에서 다룹니다.
스프링 AI의 목표와 스프링 생태계에서의 자리
스프링 AI의 대상은 스프링으로 일하는 자바 개발자입니다. 스프링 부트와 스프링 데이터 위에 만들어졌고, 생성형 AI 기능도 의존성 주입, 애너테이션, 추상화 같은 익숙한 도구로 붙입니다.
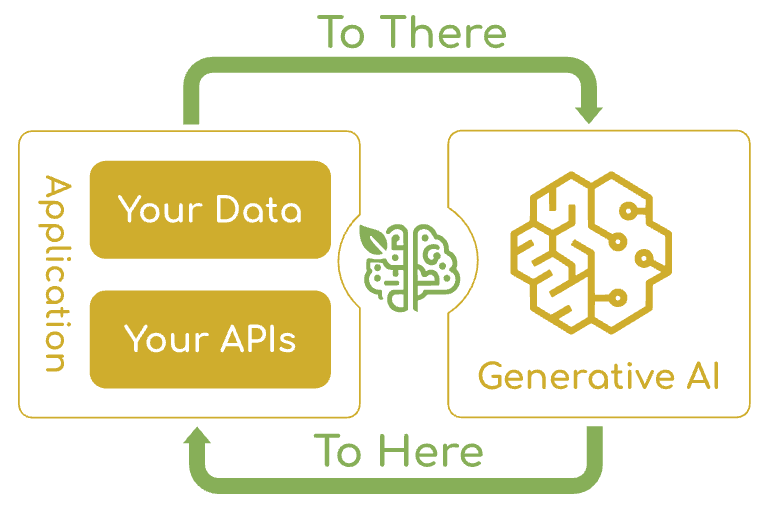
그림이 보여 주듯 스프링 AI가 해결하려는 문제는 연결입니다. 생성형 AI를 기업 애플리케이션에 도입할 때 생기는 통합 문제를 풀어, 기존 비즈니스 로직과 나란히 AI를 두는 것이 목표입니다. 이미 있는 빈, 서비스, 리포지터리를 그대로 쓰고, 데이터 임베딩과 유사도 검색과 실시간 API 호출의 복잡한 부분은 프레임워크가 처리합니다. 그래서 코드베이스를 크게 바꾸지 않고도 AI 기능을 더할 수 있습니다.
스프링 생태계 안에 있다는 사실은 엔터프라이즈 AI 애플리케이션에 필요한 네 가지 장점으로 이어집니다.
- 엔터프라이즈 통합: 스프링 애플리케이션은 이미 데이터베이스, 메시지 브로커, 캐시, 검색 엔진, 모니터링 도구와 연결되어 있고, AI 기능도 이 연결을 그대로 씁니다. 예를 들어 RAG용 벡터 저장소를 PostgreSQL의 pgvector 확장으로 두면, 기존 관계형 데이터와 벡터를 스프링 데이터 JPA 한 곳에서 관리합니다.
- 보안과 컴플라이언스: 프롬프트에는 민감한 정보가 섞일 수 있고 모델 응답도 걸러야 합니다.
@PreAuthorize,@PostAuthorize같은 스프링 시큐리티 메서드 보안으로 누가 어떤 AI API를 부를 수 있는지 제한하고, 감사 로그로 AI와 주고받은 내용을 추적합니다. - 스케일링과 고가용성: 스프링 클라우드와 쿠버네티스로 AI 서비스를 수평 확장하고, 스프링 클라우드 서킷 브레이커로 외부 AI API 장애에 대비합니다. 외부 모델이 멈추면 대체 응답을 돌려주거나 로컬 모델로 폴백할 수 있습니다.
- 관측 가능성: 스프링 부트 액추에이터와 마이크로미터로 응답 시간, 토큰 사용량, 오류율을 모으고, 마이크로미터 트레이싱으로 요청 하나가 여러 서비스를 거쳐 모델에 닿는 경로를 따라갑니다.
책의 구성과 이 사이트가 따라가는 길
기업이 원하는 것은 이미 검증된 자바 자산과 개발팀으로 AI 에이전트까지 만드는 일입니다. 스프링 AI가 2.0에 와서 에이전트 개발 기반을 갖추면서 이 요구에 답할 수 있게 됐습니다. 그래서 책은 익숙한 스프링 환경에서 AI 서비스를 한 단계씩 쌓고, 마지막에 그 결과물을 엔터프라이즈 AI 에이전트 시스템 하나로 통합하는 순서로 짜여 있습니다. 장마다 CLI 실습 프로젝트가 하나씩 있습니다.
| 장 | 다루는 기술 | 장 끝의 실습 |
|---|---|---|
| 2장 스프링 AI 프레임워크 | 올라마 로컬 환경, 프롬프트 엔지니어링, 토큰, 구조화한 출력, 대화 메모리, 어드바이저 체인 | AI 챗봇 CLI |
| 3장 스프링 AI와 RAG | ETL 파이프라인, 임베딩 모델, 벡터 데이터베이스, 모듈러 RAG | RAG AI 챗봇 CLI |
| 4장 툴 호출 | 툴 호출의 원리와 설계, 메서드와 함수 툴, 툴 실행 제어 | 툴 지원 AI 챗봇 CLI |
| 5장 스프링 AI MCP | MCP 아키텍처, MCP 클라이언트와 서버, MCP 보안 | MCP 기반 AI 챗봇 CLI |
| 6장 AI 에이전트 | 워크플로 패턴, 에이전트 루프, 컨텍스트 엔지니어링, 재귀적 어드바이저, 에이전트 스킬, 하위 에이전트, 멀티 에이전트, 메타 툴, 관측 가능성 | 엔터프라이즈 스프링 AI 에이전트 CLI |
| 부록 | 오픈AI 환경, AI 평가, 외부 에이전트 도구 연결, 스프링 AI 플레이그라운드 |
6장의 결과물은 기능 하나를 보여 주는 데서 그치지 않습니다. 메인 에이전트가 사용자의 요청을 받아 계획을 세우고, 필요한 툴을 검색해 고르고, 되돌리기 어려운 작업 앞에서는 사람의 승인을 받습니다. RAG 지식 서버와 하위 에이전트에게 일을 나눠 맡기고, 전 과정을 표준 관측 데이터로 추적합니다. 이 사이트는 책의 장 순서를 따르면서, 글마다 그 기술이 이 최종 시스템의 어디에 쓰이는지 짚습니다.
4-티어 아키텍처에서의 위치
책 6장은 최종 시스템을 설계하기 위해 AI 에이전트 서비스를 네 계층으로 나눕니다. 사용자와 만나는 T1 채널, 계획을 세우고 툴을 고르며 루프를 제어하는 T2 오케스트레이션, 툴과 MCP 서버와 하위 에이전트가 실제 일을 처리하는 T3 능력, 모델과 데이터와 인프라를 제공하는 T4 파운데이션입니다. 관측 가능성, 승인 게이트, 보안, 감사, 비용 제어는 네 계층을 가로지르는 횡단 관심사로 둡니다. 2장의 ChatClient와 어드바이저 체인은 T2, 3장의 임베딩 모델과 벡터 데이터베이스는 T4, 4장의 툴은 T3, 5장의 MCP는 T2와 T3를 잇는 경계에 들어갑니다. 이 글은 한 계층이 아니라 전체 지도의 입구이고, 계층별 정의와 배치는 4-티어 아키텍처 글에서 자세히 봅니다. 다음 글 스프링 AI 1.0에서 2.0으로, 무엇이 달라졌나에서는 이 부품들을 만드는 스프링 AI 2.0의 주요 변화를 정리합니다.
책에서 더 다루는 내용
책 1.1~1.3.2절, 1.4절
- 1.1 에이전트의 시대: 단일 에이전트가 역할 충돌과 컨텍스트 한계에 부딪히는 과정과 멀티 에이전트의 역할 분담 예
- 1.2.1 파이썬 중심의 AI 개발 생태계: 결정론적인 자바 개발과 확률적인 LLM 사이의 간극을 개발자 경험으로 풀어 쓴 설명
- 1.2.2 자바 AI 개발 생태계의 전환: 자동 구성, 툴 호출, 어드바이저가 자바 개발자의 AI 개발 방식을 어떻게 바꾸는지
- 1.3.2 스프링 생태계에서 스프링 AI의 역할과 장점: 카프카 비동기 처리와 레디스 캐싱, 서킷 브레이커 폴백, 분산 추적 같은 엔터프라이즈 활용 예
- 1.4.1 실용적인 AI 에이전트 개발 가이드: 장별 학습 목표와 실습 프로젝트가 최종 시스템으로 이어지는 흐름
참고 자료
- Spring AI 1.0 GA Released: 스프링 AI 1.0 정식 버전 출시 발표
- Spring AI 2.0.0 GA Available Now: 스프링 AI 2.0 정식 버전 출시 발표
- Spring AI Introduction: 스프링 AI 공식 레퍼런스의 소개 문서, 그림 1.1의 출처