스프링 AI로 MCP 서버 만들기: 부트 스타터부터 애너테이션까지
앞 글에서는 MCP 클라이언트로 서버에 연결해 기능을 호출했습니다. 이번에는 반대편인 MCP 서버를 스프링 AI로 만듭니다.
MCP 자바 SDK만 써도 서버는 만들 수 있습니다. 다만 전송 계층, 서버 이름과 버전, 지원 기능, 툴과 리소스 명세, 동기와 비동기 모델, 변경 알림을 모두 코드로 엮어야 합니다. 스프링 AI의 MCP 서버 부트 스타터를 쓰면 이 조립은 자동 구성이 맡고, 개발자는 기능을 스프링 빈으로 등록하면 됩니다. REST API 서버를 만들던 익숙한 스프링 방식 그대로 MCP 서버를 개발하는 셈입니다.
이 글은 책 5.3절의 내용을 서버를 만드는 순서대로 정리합니다. 예제는 3장의 RAG 기능을 MCP 서버로 공개하는 chapter5 프로젝트의 서버 코드입니다.
MCP 서버가 툴 호출에서 맡는 일
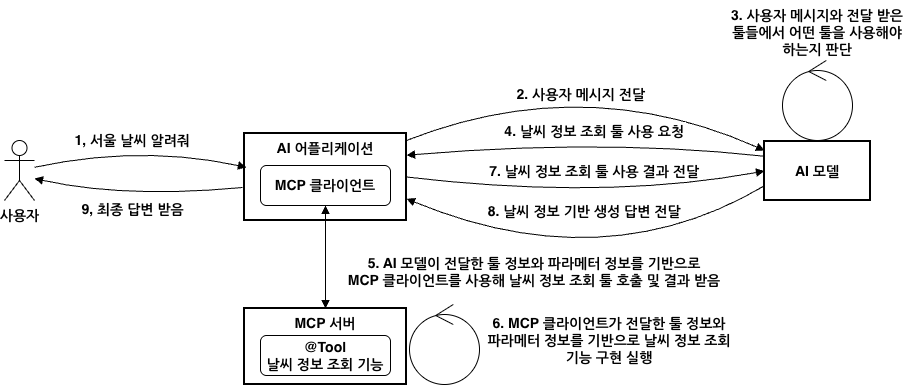
그림에서 모델이 날씨 조회 툴을 요청하는 4번까지는 애플리케이션 안에 툴을 둔 경우와 같습니다. 차이는 그다음입니다. 애플리케이션의 MCP 클라이언트가 모델이 고른 툴 이름과 파라미터를 MCP 서버로 보내고(5번), 실제 기능은 서버가 실행합니다(6번). 클라이언트는 결과를 받아 모델에 넘길 뿐입니다(7번).
서버가 할 일은 자기 기능을 툴, 리소스, 프롬프트, 자동 완성 같은 프리미티브로 정리해 공개하는 것입니다. 스프링 AI 스타터를 쓰면 이 과정이 다음처럼 달라집니다.
- 서버 타입, 전송 방식, 공개할 기능을
application.yml속성으로 정합니다. - 툴, 리소스, 프롬프트를 스프링 빈으로 등록하면 스타터가 MCP 명세로 바꿉니다.
- 이미 만든
ToolCallback,ToolCallbackProvider,@Tool기반 툴을 고치지 않고 MCP 툴로 공개합니다. @McpTool,@McpResource,@McpPrompt,@McpComplete로 메서드 단위에서 기능을 선언합니다.
스타터 고르기: 전송 방식, 웹 스택, 서버 타입
의존성을 고를 때는 성격이 다른 세 가지 선택을 나눠 보면 헷갈리지 않습니다.
첫째는 전송 방식입니다. STDIO는 클라이언트가 서버 프로세스를 직접 띄우고 표준 입출력으로 통신하는 로컬 방식입니다. Streamable HTTP는 원격 서버의 표준 전송 방식입니다. HTTP POST와 GET에 필요할 때만 SSE 스트리밍을 얹으며, 예전 HTTP with SSE 방식을 대신합니다. Stateless는 Streamable HTTP 계열이면서 세션 상태를 유지하지 않는 모드입니다.
둘째는 웹 스택입니다. 웹MVC와 웹플럭스는 프로토콜이 아니라 HTTP 요청을 어떤 I/O 모델로 처리할지 정하는 런타임 선택입니다. 스타터는 웹 서버 없이 STDIO만 지원하는 spring-ai-starter-mcp-server, 그리고 웹 스택에 맞춰 고르는 spring-ai-starter-mcp-server-webmvc와 spring-ai-starter-mcp-server-webflux로 나뉩니다. 두 웹 스타터는 모든 전송 방식을 지원하므로, 어떤 방식을 쓸지는 의존성이 아니라 설정으로 정합니다.
셋째는 spring.ai.mcp.server.type으로 정하는 서버 타입입니다. 개발자가 작성할 메서드의 반환형이 여기서 정해집니다. SYNC 서버는 일반 자바 객체를 돌려주는 메서드만, ASYNC 서버는 Mono, Flux 같은 리액티브 타입을 돌려주는 메서드만 기능으로 등록합니다. 웹플럭스를 쓴다고 서버가 저절로 ASYNC가 되지는 않습니다. 다만 웹MVC는 SYNC와, 웹플럭스는 ASYNC와 묶는 편이 자연스럽습니다.
책은 상황별 조합도 정리합니다. 로컬 전용 서버라면 spring-ai-starter-mcp-server와 STDIO, SYNC를 씁니다. 대부분의 사내 시스템에는 웹MVC와 Streamable HTTP, SYNC 조합이 적당합니다. 시스템 전체가 리액티브이고 트래픽이 크다면 웹플럭스와 Stateless, ASYNC로 수평 확장을 노릴 수 있지만, 서버가 클라이언트에 먼저 요청하는 기능은 포기해야 합니다. chapter5 예제 서버는 spring-ai-starter-mcp-server-webmvc를 쓰는 두 번째 조합입니다.
공통 설정과 프로토콜 설정
설정은 모두 spring.ai.mcp.server 아래에 두지만 역할은 두 가지입니다. 공통 속성은 전송 방식과 상관없이 서버를 식별하는 정보와 공개할 기능을 정하고, 프로토콜 속성은 클라이언트와 연결되는 방식을 정합니다. 먼저 연결 방식에 따른 배치 차이를 보겠습니다.
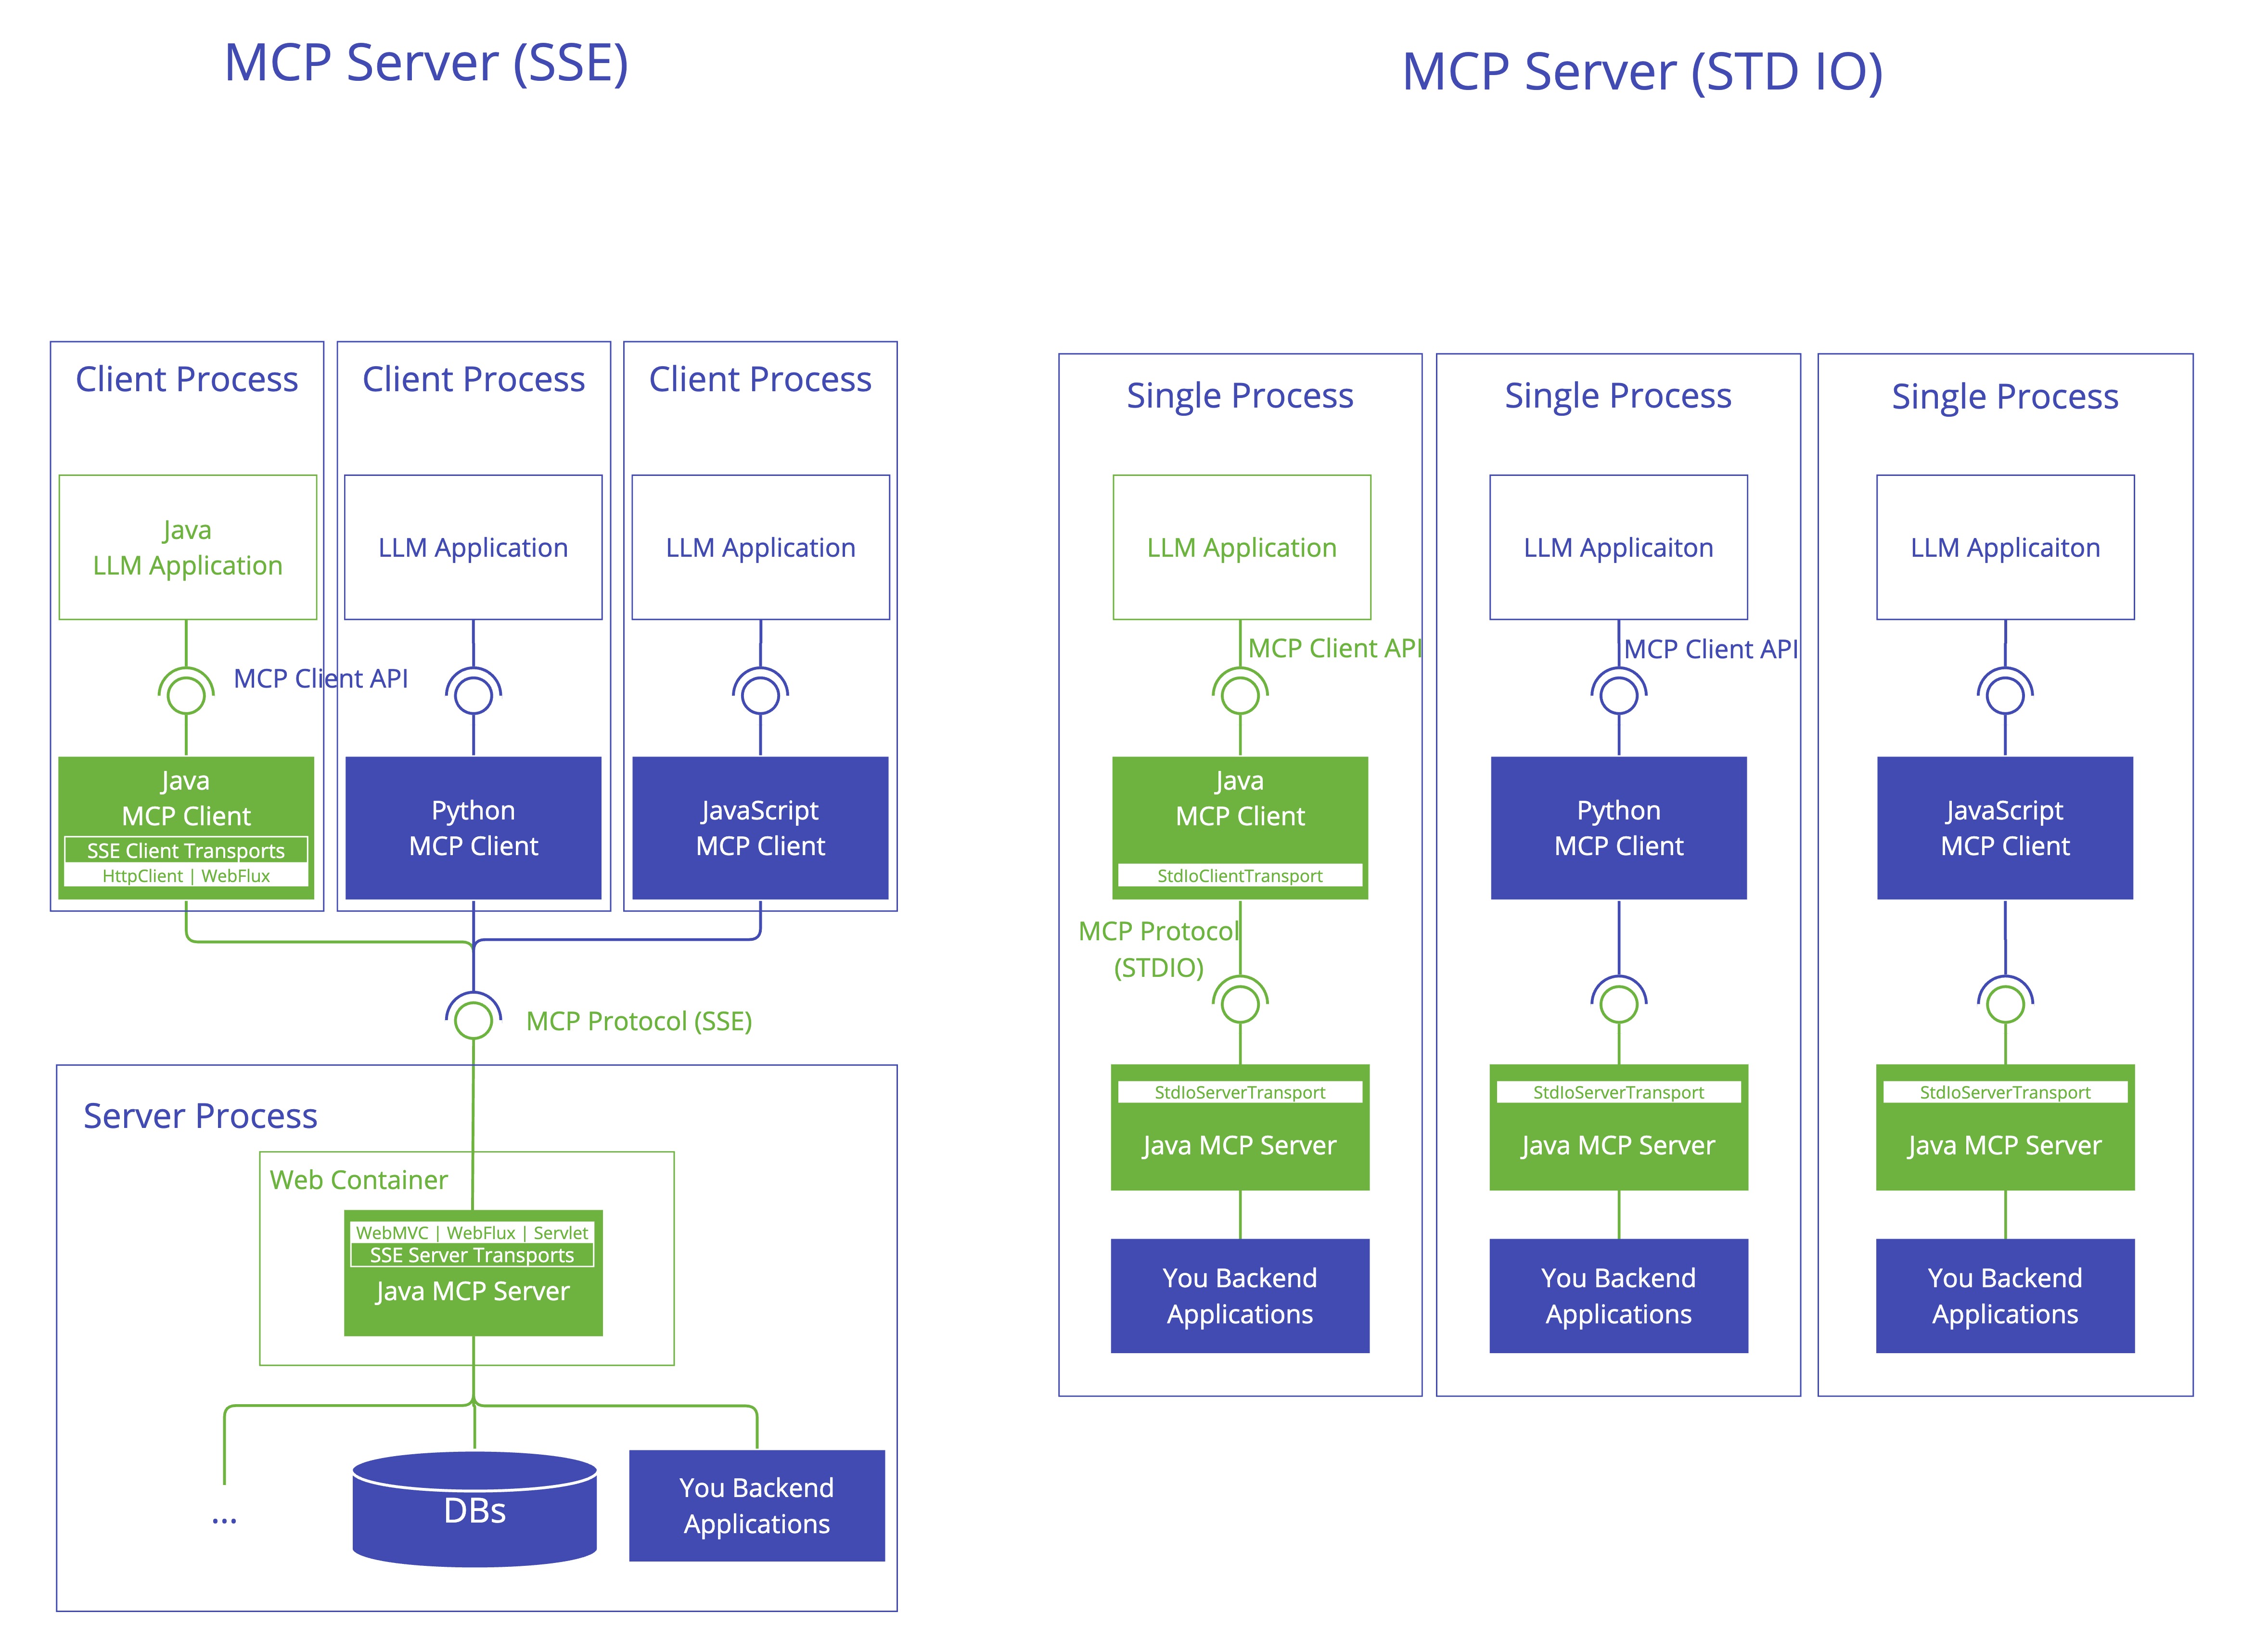
왼쪽은 HTTP 기반 서버입니다. 그림에는 SSE로 적혀 있지만 Streamable HTTP 서버도 구조가 같습니다. 여러 클라이언트가 웹 컨테이너 안의 서버 하나를 함께 씁니다. 배포와 확장, 인증과 모니터링을 서버 쪽에서 따로 관리할 수 있습니다. 오른쪽은 STDIO 서버입니다. 클라이언트가 서버를 자식 프로세스로 실행하고 생명주기까지 관리합니다. 네트워크를 열지 않고 로컬 자원을 다루거나 빠르게 실험할 때 알맞습니다.
전송 방식별 핵심 설정은 다음과 같습니다.
- STDIO:
spring.ai.mcp.server.stdio=true로 켭니다. 웹 스타터에서 켜면 웹 전송 자동 구성이 꺼져 STDIO 전용이 됩니다. 한 프로세스가 HTTP와 STDIO를 동시에 열지는 못합니다. - Streamable HTTP:
spring.ai.mcp.server.protocol의 기본값이STREAMABLE이라 생략할 수 있지만 적어 두는 편이 분명합니다. 엔드포인트는streamable-http.mcp-endpoint(기본/mcp)로 정하고,streamable-http.keep-alive-interval을 지정하면 주기적으로 모든 세션에 핑을 보냅니다. - Stateless:
spring.ai.mcp.server.protocol만STATELESS로 바꾸고 나머지는 Streamable HTTP 설정을 씁니다. 세션이 없어 수평 확장이 쉬운 대신 진행 알림, 로그, 핑, 샘플링, 추가 정보 요청처럼 서버가 클라이언트로 보내는 메시지는 쓸 수 없습니다. - SSE: 구형 클라이언트 호환용입니다. 새 프로젝트에서 고를 이유는 없습니다.
# --- [서버 모드] ---
spring:
  config.activate.on-profile: server
  main.web-application-type: servlet
server.port: 8085
spring.ai:
  model:
    chat: ollama
    embedding: ollama # 벡터 검색을 위한 임베딩 활성화
  ollama:
    embedding:
      model: bge-m3
  mcp:
    client.enabled: false
    server:
      enabled: true
      name: chapter5-rag-mcp-server
      version: 0.1.0
      type: SYNC
      protocol: STREAMABLE # Streamable HTTP 규격 사용
      instructions: "RAG 문서 ETL과 벡터 검색, 근거 기반 답변을 MCP 툴과 리소스로 제공하는 실습 서버입니다."
      streamable-http.mcp-endpoint: /mcp
application.yml의 두 번째 문서로, server 프로파일에서만 적용되는 예제 서버 설정입니다. 서블릿 웹 서버를 8085 포트로 띄우고 /mcp에 Streamable HTTP 서버를 엽니다. name, version, instructions는 서버를 소개하는 값이며, 특히 instructions는 클라이언트가 어떤 상황에서 이 서버 기능을 부를지 판단하는 안내문이 됩니다. 툴, 리소스, 프롬프트, 자동 완성의 공개 여부(capabilities)와 목록 변경 알림은 기본값이 모두 켜져 있어 따로 적지 않았습니다. 한 프로젝트가 클라이언트 실행도 겸하므로 이 프로파일에서는 MCP 클라이언트를 끕니다.
명세 빈으로 기능 등록하기
코드로 기능을 등록할 때 기본 틀은 기능별 명세 객체를 스프링 빈으로 두는 것입니다. 서버 자동 구성이 이 빈들을 모아 하나의 기능 목록으로 합칩니다.
툴은 더 간단합니다. spring.ai.mcp.server.tool-callback-converter가 기본값 true이면 컨텍스트의 ToolCallback 빈, List<ToolCallback>, ToolCallbackProvider 빈을 찾아 MCP 툴로 바꿉니다. 툴 구현 글에서 본 @Tool 메서드, MethodToolCallback, FunctionToolCallback도 ToolCallback으로 감싸 빈으로 두면 그대로 공개됩니다. 툴이 많으면 콜백을 ToolCallbackProvider 빈 하나로 모아 내보내는 편이 공개 대상을 관리하기 쉽습니다. 내부용 툴이 새어 나갈까 걱정되면 이 속성을 끄고, 공개할 툴만 McpToolUtils.toSyncToolSpecifications()나 McpToolUtils.toAsyncToolSpecifications()로 변환해 명세 빈으로 등록합니다.
리소스, 프롬프트, 자동 완성도 명세 빈으로 등록합니다. 서버 타입에 따라 Sync와 Async 명세가 나뉘고, 무상태 서버는 McpServerFeatures 대신 McpStatelessServerFeatures의 명세를 씁니다. 예제 서버는 SYNC 유상태 서버라서 McpServerFeatures의 Sync 명세를 둡니다.
    @Bean
    List<McpServerFeatures.SyncResourceSpecification> ragResources(RagMcpKnowledgeBase knowledgeBase) {
        McpSchema.Resource sources = McpSchema.Resource.builder()
                .uri("rag://sources")
                .name("rag-sources")
                .title("RAG 원천 문서 목록")
                .description("MCP RAG 서버가 인덱싱한 원천 문서와 청크 수를 제공합니다.")
                .mimeType("text/plain")
                .build();

        McpSchema.Resource pipeline = McpSchema.Resource.builder()
                .uri("rag://pipeline")
                .name("rag-pipeline")
                .title("RAG MCP 파이프라인")
                .description("문서 ETL, 벡터 검색, 근거 기반 답변 생성 흐름을 설명합니다.")
                .mimeType("text/plain")
                .build();

        return List.of(
                new McpServerFeatures.SyncResourceSpecification(sources,
                        (exchange, request) -> new McpSchema.ReadResourceResult(List.of(
                                new McpSchema.TextResourceContents(
                                        request.uri(),
                                        "text/plain",
                                        formatIndexReport(knowledgeBase.getIndexReport()))))),
                new McpServerFeatures.SyncResourceSpecification(pipeline,
                        (exchange, request) -> new McpSchema.ReadResourceResult(List.of(
                                new McpSchema.TextResourceContents(
                                        request.uri(),
                                        "text/plain",
                                        knowledgeBase.pipelineDescription()))))
        );
    }
McpSchema.Resource는 URI, 이름, 설명, MIME 타입 같은 메타데이터이고, McpServerFeatures.SyncResourceSpecification은 이 메타데이터와 읽기 요청 핸들러를 한 쌍으로 묶습니다. rag://sources는 인덱싱한 원천 문서와 청크 수를, rag://pipeline은 RAG 파이프라인 설명을 텍스트로 돌려줍니다. 같은 클래스의 ragPrompts()는 question과 category 인자로 rag_answer_question 툴 사용을 지시하는 메시지를 조립하고, ragCompletions()는 입력 중인 값으로 시작하는 카테고리 후보를 제안합니다. README의 서버 단계 ch5-server-step1부터 ch5-server-step4까지 실행하면 인덱싱 결과와 공개된 기능을 차례로 확인할 수 있습니다.
서버와 클라이언트 양방향 기능
MCP 서버는 요청에 답하기만 하지 않습니다. 클라이언트에 먼저 알리거나 클라이언트의 기능을 빌려 쓰기도 합니다. 책은 이를 두 갈래로 나눕니다.
- 이벤트형 기능: 클라이언트가 허용한 작업 경계(루트)가 바뀌면 서버가 바로 반응하는 루트 감시입니다. 툴 실행과 무관하므로
BiConsumer<McpSyncServerExchange, List<McpSchema.Root>>핸들러 빈으로 등록합니다. - 툴 실행 중 기능: 로깅, 진행률 알림, 핑은 상황을 알리는 통보형이고, 샘플링과 추가 정보 요청(Elicitation)은 클라이언트의 모델이나 사용자에게 되묻는 상호작용형입니다.
직접 만든 FunctionToolCallback 툴이라면 McpToolUtils.getMcpExchange(toolContext)로 서버 익스체인지를 꺼냅니다. 비동기 서버에서도 Optional<McpSyncServerExchange>로 받으므로 두 서버 타입을 같은 코드로 다룰 수 있습니다. 샘플링이나 추가 정보 요청 전에는 exchange.getClientCapabilities()로 클라이언트 지원 여부를 먼저 확인합니다. 무상태 서버에서는 이 기능을 쓸 수 없고, 클라이언트도 알림과 역호출을 처리할 핸들러를 갖춰야 합니다. 클라이언트 쪽은 앞 글에서 다룬 클라이언트 기능 구현과 짝을 이룹니다.
MCP 서버 애너테이션과 특수 파라미터
명세 객체를 조립하는 대신 메서드에 애너테이션을 붙여 기능을 선언할 수도 있습니다. 툴은 @McpTool, URI 템플릿 기반 리소스는 @McpResource, 프롬프트는 @McpPrompt, 자동 완성은 @McpComplete가 맡고, 애너테이션 스캐너가 이 메서드를 찾아 등록합니다.
@McpTool은 @Tool과 닮았습니다. 둘 다 파라미터로 입력 JSON 스키마를 만들고, 설명은 각각 @ToolParam과 @McpToolParam으로 보강합니다. 다만 쓰이는 자리가 다릅니다. @Tool은 애플리케이션 안에서 모델이 툴을 부르는 흐름을 위한 것이라 returnDirect 같은 응답 제어가 중요합니다. @McpTool은 tools/list와 tools/call로 외부 클라이언트에 툴을 공개하는 흐름을 위한 것이라 툴 성격 힌트, 출력 스키마, 요청 컨텍스트가 중요합니다.
    @McpTool(
            name = "rag_search_documents",
            description = "질문과 관련된 RAG 문서 조각을 벡터 검색으로 찾아 출처, 점수, 요약 텍스트를 반환합니다.",
            generateOutputSchema = true,
            annotations = @McpTool.McpAnnotations(
                    title = "RAG 문서 검색",
                    readOnlyHint = true,
                    destructiveHint = false,
                    idempotentHint = true,
                    openWorldHint = false))
    public RagSearchResponse searchDocuments(
            @McpToolParam(description = "검색할 질문 또는 키워드", required = true)
            String query,
            @McpToolParam(description = "가져올 문서 수. 기본값 5, 최대 10", required = false)
            Integer topK,
            @McpToolParam(description = "선택 필터. tech_docs, product_catalog, web_docs 중 하나", required = false)
            String category) {
        return searchService.search(query, topK, category);
    }
@McpToolParam의 설명과 required 값은 입력 스키마에 그대로 들어갑니다. 기본값과 허용값까지 적어 두면 모델이 인자를 더 정확히 넣습니다. generateOutputSchema = true는 반환 레코드 RagSearchResponse의 구조를 출력 스키마로 함께 공개합니다. @McpTool.McpAnnotations는 툴의 성격을 알리는 힌트입니다. 이 툴은 읽기 전용이고, 같은 인자로 다시 불러도 환경에 추가 효과가 없으며, 상호작용 대상이 서버 안에 닫혀 있다고 밝힙니다. 클라이언트 UI는 이런 힌트를 보고 위험한 작업 앞에서 사용자에게 확인을 받을 수 있습니다.
애너테이션 방식에서 눈여겨볼 부분은 특수 파라미터입니다. 요청 메타데이터나 진행 토큰 같은 실행 문맥을 일반 파라미터로 받으면 입력 스키마에 들어갑니다. 모델은 서버 내부 값을 모르므로 여기에 올바른 값을 넣을 수 없습니다. 스프링 AI는 실행 문맥용 타입을 스키마에서 빼고 실행 시점에 주입합니다. 메타데이터는 McpMeta, 진행 토큰은 @McpProgressToken, 요청 원문은 CallToolRequest로 받습니다. 로그, 진행률, 핑, 샘플링, 추가 정보 요청은 통합 요청 컨텍스트인 McpSyncRequestContext 하나로 처리하고, 무상태 서버에서는 가벼운 McpTransportContext를 받습니다.
    @McpTool(
            name = "rag_answer_question",
            description = "RAG MCP 서버가 문서를 검색한 뒤 검색 문서만 근거로 질문에 답합니다.",
            generateOutputSchema = true,
            annotations = @McpTool.McpAnnotations(
                    title = "RAG 근거 기반 답변",
                    readOnlyHint = true,
                    destructiveHint = false,
                    idempotentHint = false,
                    openWorldHint = false))
    public RagAnswerResponse answerQuestion(
            @McpToolParam(description = "근거 기반으로 답할 사용자 질문", required = true)
            String question,
            @McpToolParam(description = "답변에 사용할 검색 문서 수. 기본값 5, 최대 10", required = false)
            Integer topK,
            @McpToolParam(description = "선택 필터. tech_docs, product_catalog, web_docs 중 하나", required = false)
            String category,
            McpMeta meta) {
        return answerService.answer(question, topK, category,
                meta == null ? Map.of() : meta.meta());
    }
이 툴은 서버 안에서 검색과 답변 생성까지 끝내고 결과를 돌려줍니다. 클라이언트가 보는 입력 스키마에는 question, topK, category만 있고 McpMeta는 빠집니다. 서버는 클라이언트가 요청에 실어 보낸 사용자나 대화 식별자 같은 메타데이터를 받아 답변 서비스에 넘깁니다. idempotentHint는 false입니다. 이 힌트는 답이 매번 같은지가 아니라 같은 인자로 반복 호출해도 환경에 추가 효과가 없는지를 나타냅니다. MCP 명세는 이 힌트가 readOnlyHint가 false일 때만 의미가 있다고 적으므로, 읽기 전용 툴에서는 참고 정보에 가깝습니다. 두 클래스 모두 MCP 관련 코드는 얇게 두고 실제 처리는 서비스 계층에 맡깁니다.
서버 유형별 구현 기준
애너테이션을 써도 동기와 비동기, 유상태와 무상태의 규칙은 그대로입니다. spring.ai.mcp.server.type은 반환형을 정합니다. SYNC 서버에서는 레코드나 GetPromptResult 같은 일반 타입을, ASYNC 서버에서는 Mono<GetPromptResult>처럼 리액티브 타입으로 감싼 결과를 반환해야 등록됩니다. spring.ai.mcp.server.protocol은 주입받을 컨텍스트를 정합니다. 유상태 서버는 McpSyncRequestContext나 McpAsyncRequestContext를, 무상태 서버는 전송 계층 정보만 담은 McpTransportContext를 씁니다.
두 기준을 조합하면 서버 유형은 네 가지입니다. 책의 예제는 도메인 로직을 프레임워크와 무관한 서비스로 빼고, 유형별 어댑터 클래스에 @ConditionalOnProperty와 @ConditionalOnExpression을 붙여 현재 설정에 맞는 빈만 등록합니다. 이렇게 나눠 두면 나중에 양방향 통신이나 대규모 비동기 처리가 필요해져도 서비스는 그대로 두고 어댑터만 바꾸면 됩니다.
4-티어 아키텍처에서의 위치
MCP 서버는 4-티어 아키텍처의 T3 능력 티어에 속합니다. 오케스트레이션(T2)이 무엇을 할지 판단하면 그 일을 실제로 처리하는 곳이 T3입니다. MCP 경계는 이 티어를 가로질러, 같은 프로세스에서 실행하는 로컬 능력과 별도 프로세스의 MCP 서버로 떼어 낸 원격 능력을 나눕니다. 이 글의 서버는 원격 능력에 해당하며, 도메인별 서버를 더 붙여도 오케스트레이션은 고칠 필요가 없습니다. 서버를 네트워크에 열었다면 누가 호출할 수 있는지 통제해야 합니다. 그 방법은 다음 글 MCP 보안: OAuth2와 JWT로 지키는 MCP 클라이언트와 서버에서 다룹니다.
책에서 더 다루는 내용
책 5.3절
- 스타터별 지원 범위와 메이븐, 그레이들 의존성 설정, 공통 속성과 STDIO, Streamable HTTP, Stateless, SSE별 전용 속성 표
@Tool,MethodToolCallback,FunctionToolCallback을ToolCallbackProvider하나로 모으는 예제와McpToolUtils수동 등록 예제- 리소스, 프롬프트, 자동 완성 명세를 네 가지 서버 유형에 맞춰 등록하는 설정 클래스
- 루트 감시 핸들러와 핑, 로깅, 샘플링, 추가 정보 요청을 쓰는 분석 툴 예제
@McpTool,@McpToolParam,@McpTool.McpAnnotations속성 표와tools/list응답 JSON- 문서 분석과 회의실 예약 도메인으로 보는 서버 유형별
@McpTool,@McpResource,@McpPrompt,@McpComplete구현
참고 자료
- MCP ToolAnnotations: 툴 성격 힌트의 정의와 각 힌트가 의미를 갖는 조건
- MCP Java SDK Overview: 책에 실린 자바 MCP 클라이언트와 서버 아키텍처 그림의 출처