AI 에이전트 관측 가능성: Micrometer, OTel GenAI 규약, OTLP
앞 글에서 완성한 에이전트 CLI는 여러 프로세스에 걸쳐 움직입니다. 사용자의 요청 하나가 클라이언트의 에이전트 루프를 돌고, 운영 서버와 지식 서버의 툴을 호출하고, 지식 서버 안에서는 다시 벡터 검색과 모델 호출이 이어집니다. 이 흐름이 보이지 않으면 어느 구간이 느린지, 어느 에이전트가 실패했는지, 어디서 토큰이 많이 드는지 가려낼 수 없습니다.
이 글은 6장의 마지막 단계로 관측 가능성(Observability)을 켭니다. 스프링 AI가 자동으로 만드는 표준 텔레메트리와 직접 더한 루프 지표를 OTLP로 내보내는 구성을 보고, 끝으로 4-티어 아키텍처 전체를 한 번 되짚습니다.
관측을 설계 단계부터 넣는 이유
책의 설계는 관측을 시스템이 완성된 뒤에 덧붙이는 기능으로 보지 않습니다. 에이전트가 여러 프로세스로 흩어지면 느린 호출, 실패한 에이전트, 비용이 커진 구간을 추적할 수 있어야 운영이 가능하기 때문입니다. 그래서 처음부터 표준 신호를 만들어 바깥의 관측 시스템에 넘기는 구조를 설계에 넣습니다.
이 설계에서는 툴 경계가 곧 관측 경계입니다. 클라이언트가 MCP 서버를 부르는 호출이 그대로 하나의 추적 구간이 되므로, 프로세스가 나뉘어 있어도 실행 흐름을 이어 볼 수 있습니다. 애플리케이션은 관측 도구를 직접 만들지 않고 표준 신호를 내보내는 데까지만 책임집니다. 코어 에이전트를 만들 때 어드바이저 체인에 루프 지표 어드바이저를 미리 넣어 둔 것도 이 준비의 일부입니다. 그래서 마지막 단계에서는 관측을 위한 코드를 새로 쓰지 않고 의존성과 설정만 더합니다.
스프링 AI 관측의 구조: Micrometer와 OTel GenAI 규약
스프링 AI는 스프링 생태계의 Micrometer 관측 기능 위에서 동작합니다. ChatClient, 어드바이저, ChatModel, EmbeddingModel, ImageModel, VectorStore가 메트릭과 트레이스를 스스로 기록하므로, 지금까지 만든 코드를 거의 바꾸지 않아도 실행 흐름이 스팬과 메트릭으로 남습니다. 에이전트를 볼 때 특히 쓸모 있는 관측은 다음과 같습니다.
spring.ai.chat.client: 메인 에이전트의 한 턴. 호출 방식(call, stream), 적용된 어드바이저 목록, 대화 ID, 툴 이름이 남습니다.gen_ai.client.operation: 채팅 모델과 임베딩 모델 호출. 요청 모델과 응답 모델, 입력과 출력 토큰 수가 남습니다.spring.ai.tool: 툴 실행. 툴 정의 이름과 호출 ID가 남습니다.spring.ai.advisor: 어드바이저별 이름과 순서값이 남습니다.db.vector.client.operation: 벡터 스토어의 조회, 추가, 삭제 작업이 남습니다.
한 턴을 기록하는 spring.ai.chat.client 스팬 아래에는 그 턴에서 일어난 모델 호출들이 자식 스팬으로 붙습니다. 그래서 에이전트 한 턴과 그 안의 모델 호출을 한 트레이스 안에서 이어 볼 수 있습니다.
더 눈여겨볼 점은 이름 체계입니다. 모델 호출에 붙는 gen_ai.request.model, gen_ai.usage.input_tokens 같은 속성과 gen_ai.client.token.usage 메트릭은 OpenTelemetry의 생성형 AI 시맨틱 규약(OTel GenAI Semantic Conventions)에서 정한 이름입니다. 특정 제품 전용 형식이 아니므로 여러 관측 시스템이 같은 뜻으로 해석할 수 있습니다.
프롬프트와 응답 내용은 기본으로 기록하지 않습니다. 사용자 입력, 검색 문서, 내부 업무 데이터가 그대로 담길 수 있고 크기도 빠르게 불어나기 때문에, 기본값은 토큰 수, 모델 이름, 소요 시간 같은 메타데이터만 남깁니다. spring.ai.chat.client.observations.log-prompt, spring.ai.chat.client.observations.log-completion, spring.ai.tools.observations.include-content를 켜면 내용도 기록됩니다. 다만 민감 정보가 외부 시스템까지 흘러가므로, 실제 서비스에서 켤 때는 마스킹과 접근 권한, 데이터 보관 기간을 같이 정해 두어야 합니다.
OTLP 내보내기 설정
관측 신호를 밖으로 보내려면 의존성 네 개가 필요합니다.
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-actuator</artifactId>
        </dependency>
        <dependency>
            <groupId>io.micrometer</groupId>
            <artifactId>micrometer-tracing-bridge-otel</artifactId>
        </dependency>
        <dependency>
            <groupId>io.opentelemetry</groupId>
            <artifactId>opentelemetry-exporter-otlp</artifactId>
        </dependency>
        <!-- 메트릭(표준 + 커스텀 어드바이저 지표)을 OTLP로 내보내는 레지스트리 -->
        <dependency>
            <groupId>io.micrometer</groupId>
            <artifactId>micrometer-registry-otlp</artifactId>
        </dependency>
액추에이터가 관측 인프라를 열고, micrometer-tracing-bridge-otel이 Micrometer 관측을 OpenTelemetry 트레이싱에 연결합니다. 트레이스는 opentelemetry-exporter-otlp가, 메트릭은 micrometer-registry-otlp가 OTLP로 내보냅니다. 관측과 트레이싱을 잇는 TracingAwareMeterObservationHandler는 스프링 부트 액추에이터가 자동으로 등록하므로 계측 코드를 따로 쓸 필요가 없습니다.
설정은 application.yml에 둡니다.
management:
  endpoints:
    web:
      exposure:
        include: metrics
  tracing:
    sampling:
      probability: 1.0
  otlp:
    tracing:
      endpoint: http://localhost:4318/v1/traces    # OTLP/HTTP 트레이스 엔드포인트
    metrics:
      export:
        url: http://localhost:4318/v1/metrics       # OTLP/HTTP 메트릭 엔드포인트(표준 + 커스텀 지표)
학습 단계에서는 모든 요청을 추적하도록 표본 비율을 1.0으로 두고, 트레이스와 메트릭을 각각 OTLP/HTTP 엔드포인트(4318 포트)로 보냅니다. 이 설정은 모든 프로파일이 함께 쓰므로 클라이언트와 두 MCP 서버가 같은 곳으로 신호를 보냅니다. 메트릭 엔드포인트는 웹 서버를 띄우는 MCP 서버에서만 HTTP로 열리고, 웹 서버 없이 도는 CLI 클라이언트에서는 열리지 않습니다. 수집기가 없어도 실습 실행에는 지장이 없습니다.
신호가 실제로 쌓이는지는 액추에이터로 확인합니다. 책에서는 지식 서버로 RAG 답변을 한 번 만든 뒤 http://localhost:8086/actuator/metrics/gen_ai.client.token.usage를 조회합니다. 결과를 보면 관측 코드 없이도 토큰 사용량이 표준 메트릭으로 집계되고, 작업 종류(chat, embedding), 모델 이름(qwen3.5:4b, bge-m3), 토큰 종류(input, output, total)가 태그로 붙어 있습니다. 같은 방식으로 gen_ai.client.operation에서는 모델 호출 횟수와 소요 시간을, spring.ai.chat.client에서는 에이전트 턴 단위의 호출을 확인합니다.
커스텀 지표로 툴 루프 들여다보기
스프링 AI의 자동 계측이 잡는 것은 프레임워크가 정해 둔 지점의 동작입니다. 하지만 한 요청에서 루프가 몇 바퀴 돌았는지, 어느 툴이 많이 불렸는지, 반복마다 토큰이 얼마나 쓰였는지는 표준 신호에서 곧바로 읽히지 않습니다. 이런 지표는 재귀적 어드바이저 글에서 소개한 ToolLoopMetricsAdvisor가 기록합니다.
    @Override
    public ChatClientResponse after(ChatClientResponse response, AdvisorChain chain) {
        ChatResponse chatResponse = response.chatResponse();
        if (chatResponse == null) {
            return response;
        }
        // 루프 1회 반복마다 한 번 집계
        registry.counter("agent.tool.loop.iterations").increment();
        chatResponse.getResult().getOutput().getToolCalls()
                .forEach(toolCall ->
                        registry.counter("agent.tool.calls", "tool", toolCall.name()).increment());
        Usage usage = chatResponse.getMetadata().getUsage();
        if (usage != null && usage.getTotalTokens() != null) {
            DistributionSummary.builder("agent.tool.loop.tokens")
                    .baseUnit("tokens")
                    .register(registry)
                    .record(usage.getTotalTokens());
        }
        return response;
    }

    @Override
    public int getOrder() {
        // ToolCallingAdvisor(+300) 안쪽이므로 매 반복 실행
        return BaseAdvisor.HIGHEST_PRECEDENCE + 400;
    }
BaseAdvisor를 구현했으므로 call과 stream 모두에서 동작하고, 순서값이 ToolCallingAdvisor(+300)보다 큰 +400이라 툴 루프 안쪽에 자리합니다. 그래서 루프가 한 번 돌 때마다 after()가 실행되어 그 반복의 응답을 살핍니다. 기록하는 지표는 세 가지입니다. agent.tool.loop.iterations는 반복 횟수를 세는 카운터, agent.tool.calls는 tool 태그로 툴별 호출 수를 세는 카운터, agent.tool.loop.tokens는 반복당 토큰 수를 기록하는 분포 요약입니다.
이 지표가 있으면 느린 요청의 원인을 나눠 볼 수 있습니다. 모델 응답이 느렸는지, 루프가 너무 많이 돌았는지, 특정 툴이 지나치게 불렸는지 구분됩니다. 커스텀 지표도 표준 신호와 같은 MeterRegistry에 모이고 같은 OTLP 익스포터로 나가므로, 외부 관측 시스템에서 표준 토큰 지표와 루프 지표를 함께 조회할 수 있습니다.
분산 멀티 에이전트의 표준 관측 흐름
클라이언트와 두 MCP 서버가 모두 같은 규약의 신호를 한 OTLP 엔드포인트로 보내므로, 에이전트 루프와 모델 호출, MCP 툴 호출, 서버 안 하위 에이전트의 검색까지 요청 하나가 남긴 흔적이 한곳에 모입니다.
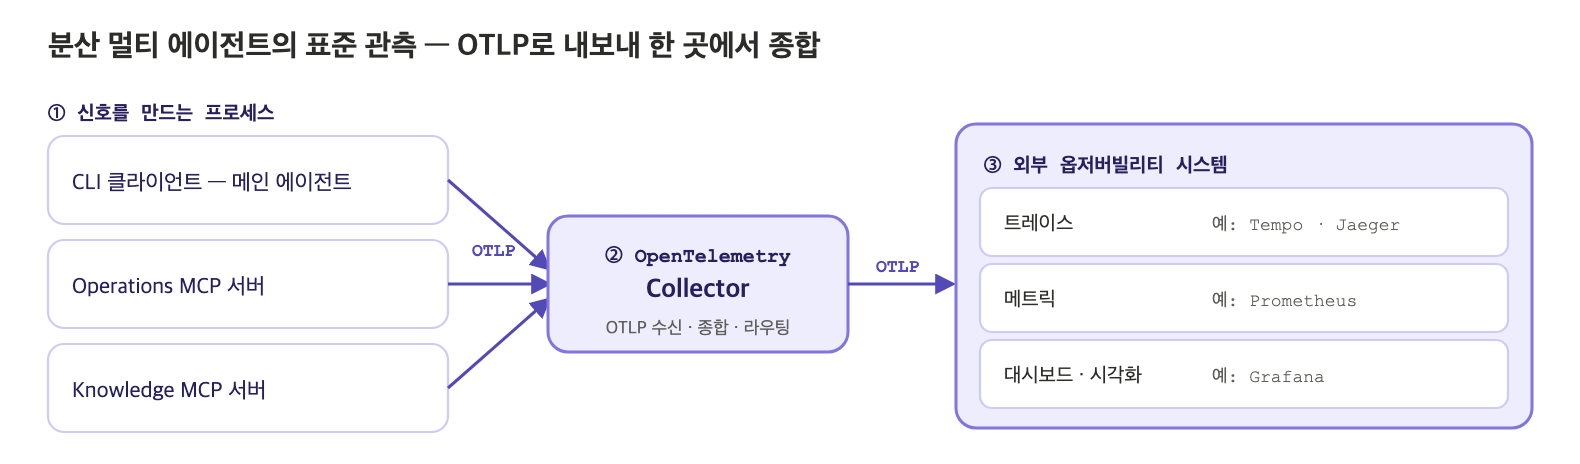
각 프로세스가 보낸 신호는 OpenTelemetry 컬렉터가 받아 외부 관측 시스템으로 넘깁니다. 컬렉터는 텔레메트리를 받고 가공해 내보내는 벤더 중립 구성 요소입니다. receiver, processor, exporter를 조합해 파이프라인을 만들고, 받은 신호를 하나 이상의 백엔드로 보낼 수 있습니다. 그림처럼 트레이스는 템포(Tempo)나 예거(Jaeger)에, 메트릭은 프로메테우스에 저장하고 그라파나로 시각화할 수 있습니다.
이렇게 나누면 역할이 분명해집니다. 애플리케이션이 알아야 할 것은 OTLP 엔드포인트 주소뿐이고, 어디에 저장하고 어떻게 보여 줄지는 컬렉터와 관측 스택이 정합니다. 관측 백엔드를 바꿔도 애플리케이션의 코드와 설정은 거의 바뀌지 않고, 재시도, 배치, 암호화, 민감 정보 필터링 같은 처리는 서비스 옆에 둔 컬렉터에 맡길 수 있습니다. 예제 저장소는 OTLP 엔드포인트까지만 설정해 두었으므로 컬렉터와 백엔드는 운영 환경에 맞춰 구성합니다.
4-티어 아키텍처에서의 위치
관측 가능성은 특정 티어에 속하지 않고 채널부터 파운데이션까지 모든 계층을 가로지르는 횡단 관심사입니다. 질문, 계획, 위임, 툴 검색 같은 오케스트레이션 행위도, MCP 경계 너머 하위 에이전트의 모델 호출도 모두 관측 대상입니다. 이 글에서 클라이언트와 서버 양쪽에 같은 관측을 켜면서 6장의 시스템은 운영할 수 있는 형태가 됩니다.
6장의 흐름을 4-티어로 돌아보면 이렇습니다. 채널(T1)의 CLI는 에이전트 코어와 분리되어 있어 웹 같은 다른 채널로 바꿀 수 있습니다. 오케스트레이션(T2)에서는 SpringAIAgent가 ChatClient와 어드바이저 체인 위에서 에이전트 루프를 돌리고, 재귀적 어드바이저가 그 루프를 제어합니다. 시스템 프롬프트, 대화 메모리, 스킬, 동적 툴 탐색은 모델에 무엇을 보여 줄지 정하는 컨텍스트 엔지니어링의 구현입니다. 능력(T3)의 로컬 툴, MCP 서버, 하위 에이전트는 단일 툴 인터페이스로 묶이고, 파운데이션(T4)의 모델과 벡터 스토어가 이를 뒷받침합니다. T2와 T3 사이를 MCP라는 표준 인터페이스로 나눠 두었기 때문에 능력을 넓혀도 오케스트레이션 코드는 그대로입니다. 승인 게이트와 관측 가능성은 이 전체를 가로지릅니다.
지금까지는 올라마의 qwen3.5:4b 로컬 모델로 실습했습니다. 실무에서는 상용 모델과 결과를 비교하거나, 답변이 근거에 맞는지 검증하거나, 직접 만든 MCP 서버를 다른 AI 에이전트에 연결해야 할 때가 있습니다. 그 방법은 다음 글 부록: 오픈AI 전환, AI 평가, 외부 AI 에이전트 연결에서 다룹니다.
책에서 더 다루는 내용
책 6.6.7절
- 통합 CLI의 구현과 여러 턴에 걸친 실행 결과
- 스프링 AI가 자동으로 계측하는 컴포넌트별 관측 이름과 핵심 속성 표
gen_ai.client.token.usage조회 결과 전체와 태그 읽는 법- 커스텀 지표 세 가지로 느린 요청의 원인을 가려내는 방법
- OpenTelemetry 컬렉터를 앞에 둔 외부 관측 스택의 표준 구성
참고 자료
- Spring Boot Reference: Tracing: 스프링 부트에서 Micrometer Tracing을 설정하는 방법
- Spring AI Reference: Observability: 스프링 AI가 계측하는 관측 항목과 속성 목록
- OpenTelemetry Collector Architecture: receiver, processor, exporter로 이루어진 컬렉터 파이프라인 구조