토큰과 구조화한 출력: 모델의 답을 자바 객체로 받기
앞 글에서는 ChatClient로 모델을 호출하고 프롬프트로 답의 방향을 잡았습니다. 이 글은 그 호출의 양 끝을 봅니다. 들어가는 쪽에서 텍스트는 토큰으로 바뀌어 모델에 전달되고, 나오는 쪽에서 모델은 사람이 읽는 문장을 돌려줍니다.
두 지점 모두 설계에 바로 영향을 줍니다. 토큰 수는 한 번에 넣을 수 있는 정보의 양과 비용을 정합니다. 모델이 돌려주는 자유로운 문장은 필드와 타입으로 움직이는 자바 코드와 잘 맞지 않습니다. "서울의 인구는 약 970만 명입니다" 같은 답에서 숫자를 뽑아내는 파싱 코드는 모델이 표현을 조금만 바꿔도 깨집니다.
그래서 앞부분에서는 토큰을 개발자 관점에서 정리하고, 뒷부분에서는 모델의 답을 자바 레코드로 받는 구조화한 출력과 네이티브 구조화한 출력을 예제 코드와 함께 살펴봅니다.
개발자 관점에서 본 토큰
토큰은 모델이 텍스트를 다루는 최소 단위입니다. LLM은 입력 텍스트를 정수로 된 토큰 열로 바꾼 뒤 연산합니다. 오픈AI 토크나이저에 문장을 넣어 보면 토큰마다 다른 색으로 구분되고, 각 토큰에 대응하는 정수 값도 볼 수 있습니다.
토큰을 글자 수 정도로 여기면 설계에서 놓치는 것이 생깁니다. 개발자가 챙길 지점은 세 가지입니다.
- 컨텍스트 윈도우: 모델이 한 번에 받는 토큰 수에는 상한이 있습니다. 초기 GPT-3는 약 2,000토큰이었고 GPT-5와 o1 계열은 200K 이상을 받습니다. 그렇다고 많이 넣을수록 좋은 것은 아닙니다. 긴 입력의 가운데 있는 내용을 모델이 놓치는 중간 손실(lost in the middle) 현상이 생길 수 있어서, 무엇을 넣을지 골라야 합니다.
- 비용: 클라우드 LLM은 쓴 토큰만큼 과금합니다. 출력 토큰 단가가 입력보다 비싼 경우가 많으므로, 답이 불필요하게 길어지지 않도록 프롬프트로 조절하는 것이 비용 관리의 기본입니다.
- 언어 이해도: 텍스트를 의미 있는 단위로 잘라 내는 토크나이저일수록 모델이 문맥을 잘 잡습니다. 예전 모델에서 한국어 성능이 낮았던 큰 이유도 한글이 뜻 없는 조각으로 잘게 쪼개졌기 때문입니다.
한국어 토큰 효율과 하이브리드 프롬프트 전략
"한글은 토큰이 많이 드니 영어로 번역해서 넣어야 한다"는 말은 초기 모델에서는 맞았습니다. 최신 토크나이저에서는 사정이 다릅니다. 같은 인사말을 한글과 영어로 넣었을 때 토크나이저 세대별 토큰 수는 다음과 같습니다.
| 세대 | 모델 | 토크나이저 | 안녕하세요. 만나서 반갑습니다. | Hello. Nice to meet you. |
|---|---|---|---|---|
| 최신 | GPT-5, o1/o3 | o200k_base |
9토큰 | 7토큰 |
| 과도기 | GPT-4, GPT-3.5 | cl100k_base |
14토큰 | 7토큰 |
| 레거시 | GPT-3 | r50k_base |
38토큰 | 7토큰 |
GPT-3 세대에서 한글 문장은 영어보다 5배 넘게 토큰을 썼지만 최신 세대에서는 거의 차이가 없습니다. 비용 때문에 영어를 고집할 이유는 줄었습니다. 오히려 번역을 거치면 '은/는'과 '이/가' 같은 조사의 차이나 높임말의 뉘앙스가 사라지기 쉽습니다. 한국어로 바로 지시하면 이런 의도가 그대로 전달되고, 번역 단계가 없으니 구성이 단순해지고 응답 지연도 줄어듭니다.
그렇다고 프롬프트 전부를 한국어로 쓰자는 것은 아닙니다. 책은 영어 구조와 한국어 내용을 섞는 하이브리드 프롬프트를 권합니다. 근거로 드는 논문 「Do Multilingual LLMs Think in English?」는 다국어 모델도 비영어 입력을 처리할 때 영어 중심의 표현 공간을 비교적 안정적으로 활용하는 경향이 있다고 보고합니다. 그래서 역할(Role), 작업(Task), 출력 형식(Output Format), 제약 조건(Constraints) 같은 뼈대는 영어로 세우고, 구체적인 수행 지침과 맥락은 한국어로 씁니다. 어떤 조합이 잘 맞는지는 모델마다 다를 수 있으니 쓰는 모델로 확인해 보는 편이 좋습니다. 영어 헤더는 구조를 나누는 데도 쓸모가 있습니다. 한국어로만 길게 쓴 프롬프트에서는 어디까지가 지시이고 어디부터가 처리할 데이터인지 모델이 헷갈릴 수 있기 때문입니다.
# Role
You are an expert Java Developer and Code Reviewer.
# Task
Analyze the provided Java code and suggest improvements.
다음의 구체적인 기준에 맞춰 코드를 정밀하게 리뷰해 주세요:
1. "가독성 (Readability):" 변수명이 직관적인지, 불필요한 주석은 없는지 확인해 주세요.
(2, 3번 기준 생략)
# Output Format
Please provide the response in the following format:
- "문제점 요약 (Summary):" (이슈를 3줄 이내로 요약)
(나머지 항목 생략)
# Constraints
- Explain specifically in Korean.
- Do not change the business logic.
책에 실린 코드 리뷰 에이전트용 프롬프트에서 뼈대만 추린 것입니다. 뉘앙스가 중요한 리뷰 기준은 한국어로 적었습니다.
프레임워크가 대신 쓰는 형식 지침
LLM은 확률로 다음 토큰을 고르는 생성기라서 같은 질문에도 답의 형식이 조금씩 달라질 수 있습니다. 스프링 AI의 구조화한 출력은 이런 답을 곧바로 자바 객체로 바꿔 줍니다.
사용할 때는 .call().entity(ActorsFilms.class)처럼 받을 타입만 넘기면 됩니다. 프롬프트에 JSON으로 답하라고 쓰지 않았는데도 동작하는 이유는, 스프링 AI가 대상 클래스를 분석해 형식 지침을 만들고 사용자 메시지 뒤에 덧붙이기 때문입니다. BeanOutputConverter의 getFormat()이 만드는 지침에는 RFC8259 규격의 JSON으로만 답하고, 설명이나 마크다운 코드 블록을 넣지 말고, 뒤에 붙은 JSON 스키마를 따르라는 내용이 영어로 들어 있습니다.
스키마도 대상 클래스에서 자동으로 만들어집니다. 스프링 AI는 필드와 타입, 그리고 @JsonProperty 같은 애너테이션을 리플렉션으로 읽고, jsonschema-generator와 Jackson 모듈을 써서 Draft 2020-12 규격의 스키마를 만든 뒤 지침 템플릿에 넣습니다. 프롬프트 문구도 스키마 생성 로직도 개발자가 직접 짤 필요가 없습니다.
구조화한 출력의 아키텍처
구조화한 출력은 요청 전처리와 응답 후처리가 이어진 파이프라인입니다.
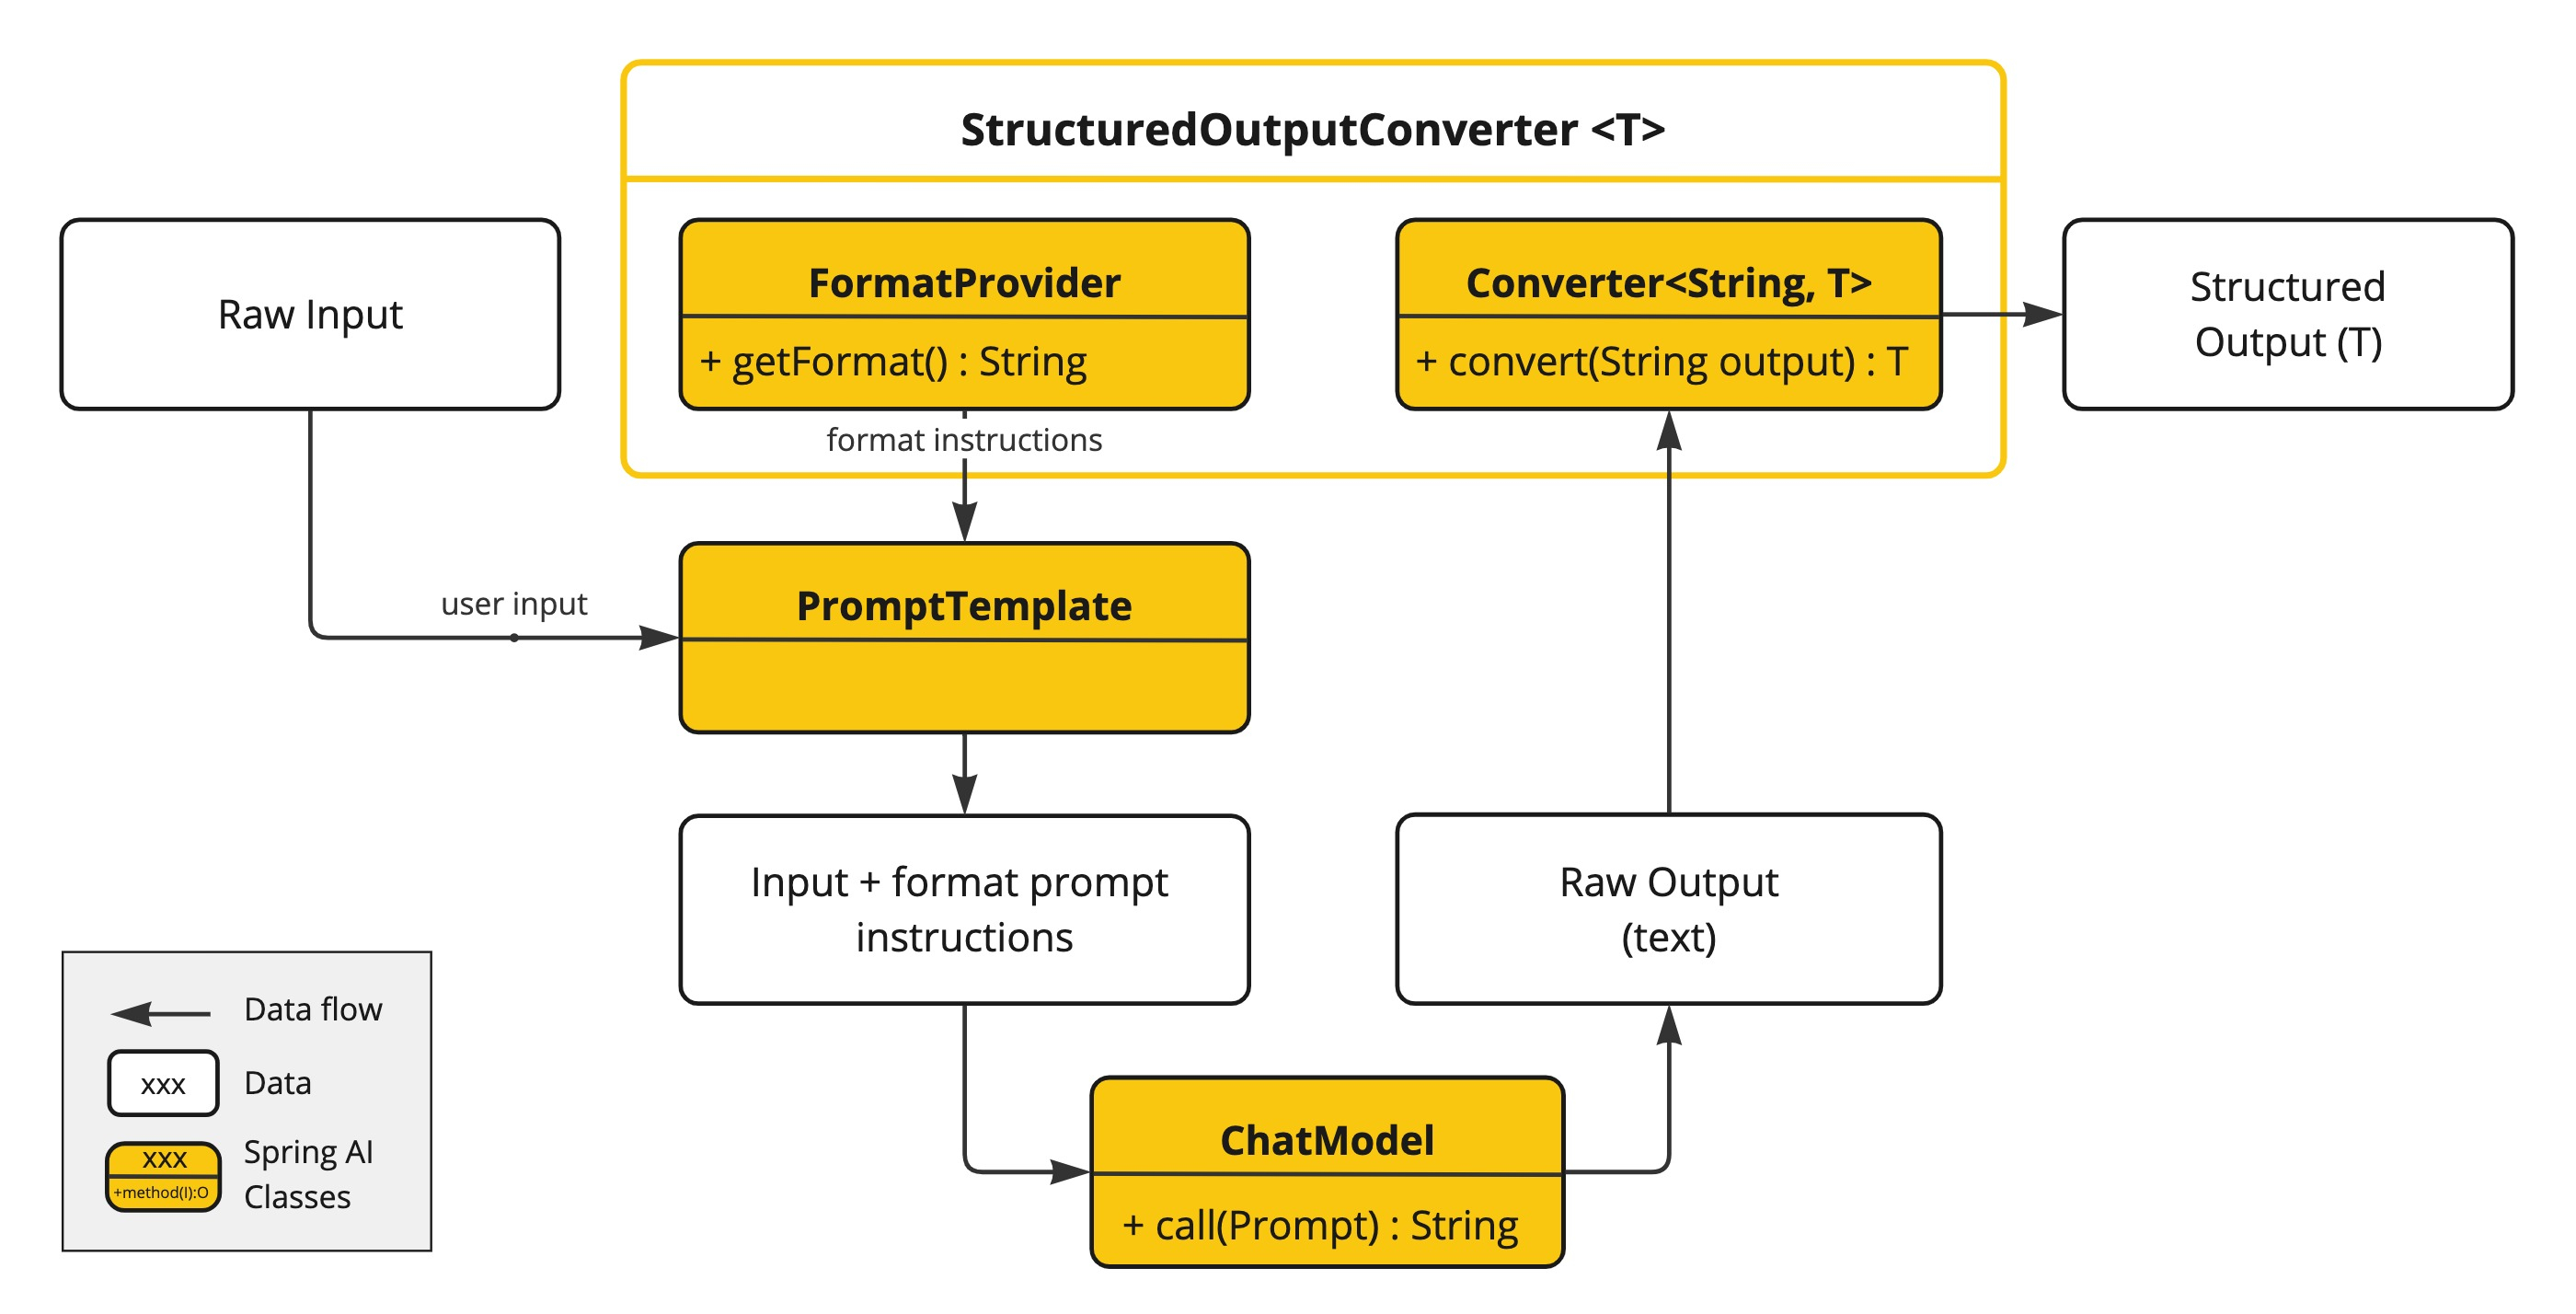
- 요청 전처리: 변환기가 대상 타입으로 JSON 스키마를 만들고,
getFormat()이 돌려준 지침을 사용자 프롬프트 뒤에 합칩니다. - 모델 호출: 모델은 합쳐진 지침에 따라 대화체 문장 대신 JSON 문자열을 돌려줍니다.
- 응답 후처리: 스프링 AI가 모델의 원시 텍스트를 먼저 받아 Jackson으로
List나Map, 사용자 정의 객체로 역직렬화합니다. 이 과정에서 타입이 맞는지도 확인합니다.
이 흐름의 중심에 있는 인터페이스가 StructuredOutputConverter<T>입니다. Converter<String, T>와 FormatProvider를 함께 확장하므로 역할이 둘로 나뉩니다. FormatProvider의 getFormat()은 모델에 보낼 형식 지침을 만들고, Converter의 convert()는 모델이 돌려준 문자열을 T로 바꿉니다.
StructuredOutputConverter 구현체 고르기
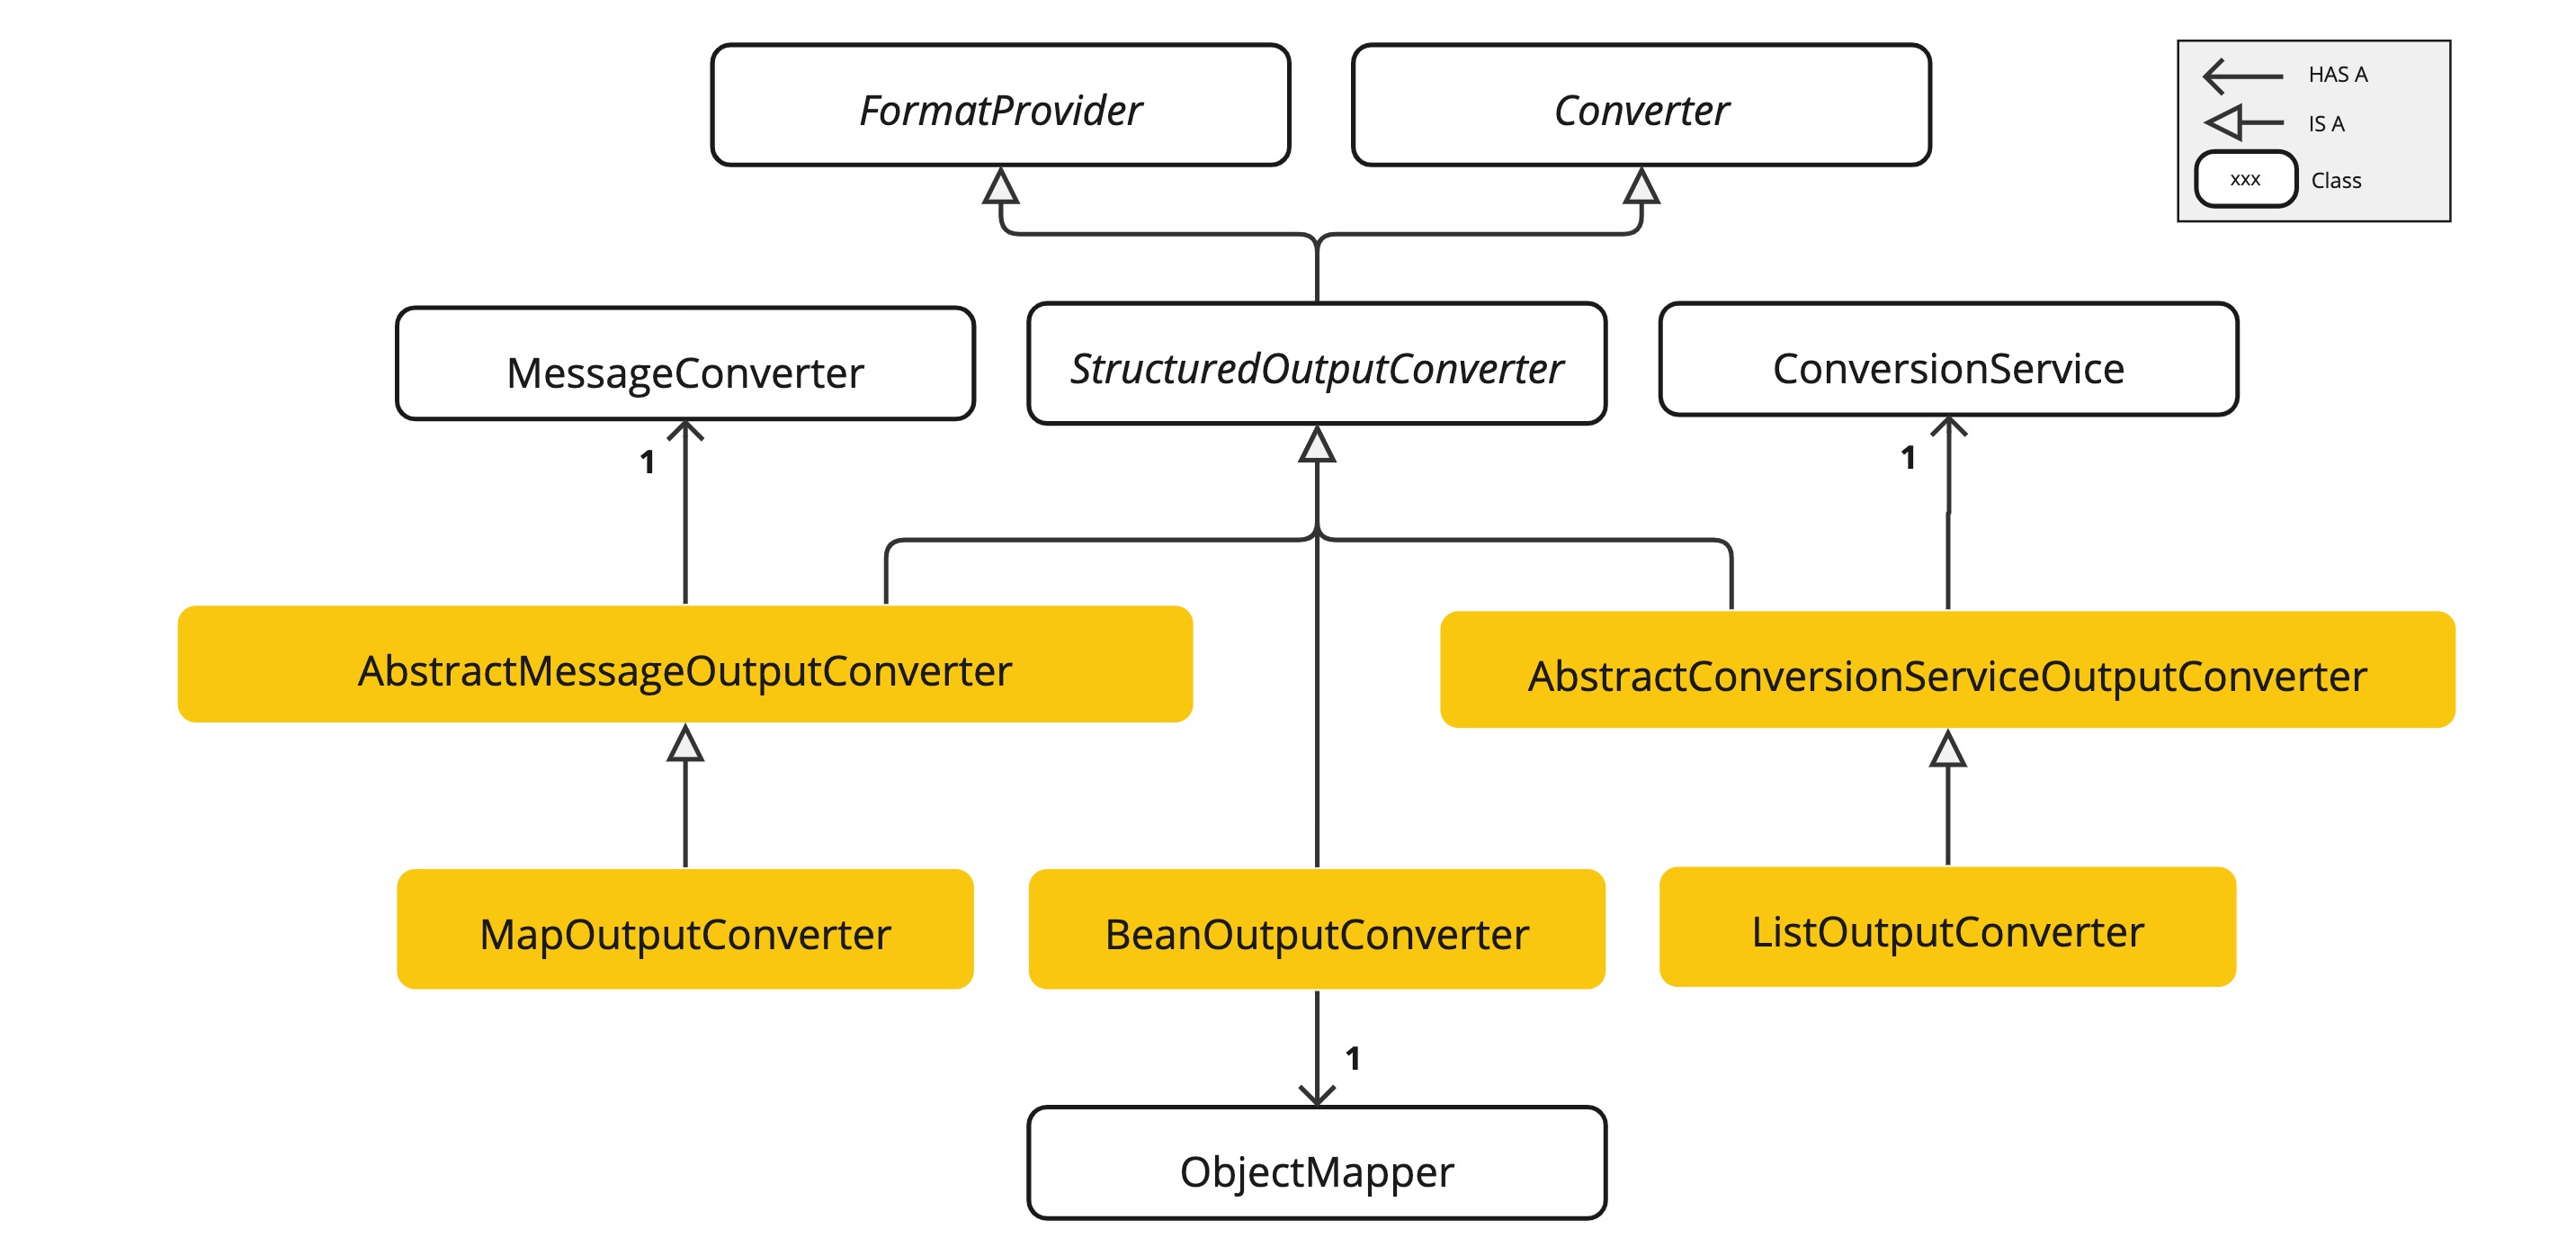
스프링 AI의 변환기는 받을 데이터의 모양에 따라 나뉘고, 그림처럼 저마다 기대는 스프링 기술이 다릅니다.
BeanOutputConverter<T>: 자바 클래스로 JSON 스키마를 만들어 POJO나 레코드에 매핑합니다. 대부분의 비즈니스 로직에서 쓰는 기본 선택지이며 타입 안전하게 값을 다룰 수 있습니다.MapOutputConverter: 키가 그때그때 달라지는 JSON을 스키마 검증 없이Map<String, Object>로 옮깁니다..entity(new MapOutputConverter())처럼 인스턴스를 넘기며, 내부에서MessageConverter를 씁니다.ListOutputConverter: JSON 대신 쉼표로 구분한 목록을 받아List<String>으로 나눕니다. 스키마를 분석할 필요 없이 잘라 내기만 하면 되므로 가볍고, 조각의 타입 변환은 생성자로 넘긴DefaultConversionService가 맡습니다.
BeanOutputConverter를 쓸 때 알아 둘 점이 두 가지 있습니다. 하나는 필드 순서입니다. 모델은 앞에서부터 차례로 글을 써 내려가므로, 판단이 필요한 객체라면 결론보다 근거를 먼저 쓰게 할 때 정확도가 올라갑니다. 책은 이를 생각의 사슬 효과로 설명하고, @JsonPropertyOrder로 reasoning 필드를 장르나 추천 점수보다 앞에 둔 영화 분석 레코드를 예로 듭니다. 다른 하나는 제네릭 타입입니다. 자바의 타입 소거 때문에 List<MovieAnalysis> 같은 타입은 클래스 리터럴로 넘길 수 없으므로, new ParameterizedTypeReference<List<MovieAnalysis>>() {}로 타입 정보를 실행 시점까지 전달합니다.
기본 변환기로 부족하면 직접 만듭니다. XML이나 YAML 같은 구조 포맷이 필요하면 StructuredOutputConverter를 구현해 getFormat()에는 그 포맷으로 답하라는 지침을, convert()에는 XmlMapper 같은 파서 호출을 넣습니다. 쉼표 대신 파이프(|)로 구분한 목록처럼 텍스트 규칙만 바꾸고 싶다면, 그림 오른쪽의 AbstractConversionServiceOutputConverter를 상속해 지침과 분리 규칙만 새로 정의하면 됩니다.
네이티브 구조화한 출력
형식 지침을 프롬프트 텍스트로 보내는 방식에는 약점이 있습니다. 모델이 지침을 무시하거나 답에 마크다운 기호를 섞으면 파싱이 실패합니다. 이 문제를 줄이려고 모델 제공자 쪽 기능이 두 단계로 발전했습니다.
먼저 나온 것은 빌트인 JSON 모드입니다. 문법적으로 올바른 JSON만 내도록 모델을 강제하는 옵션으로, 스프링 AI에서는 공통 인터페이스가 아니라 모델별 옵션 클래스로 켭니다. 오픈AI는 OpenAiChatOptions의 responseFormat 타입을 JSON_OBJECT로, 올라마는 OllamaChatOptions의 format을 json으로 지정합니다. 쉼표가 빠지거나 괄호가 닫히지 않는 오류는 사라지지만 원하는 키 구조까지 지켜진다는 보장은 없습니다. name을 요청해도 userName이 돌아와 객체 매핑이 실패할 수 있습니다.
네이티브 구조화한 출력은 한 걸음 더 나아가 JSON 스키마 자체를 API 파라미터로 모델에 보냅니다. 구조를 문장으로 설명하지 않고 스키마로 강제하므로 형식 오류가 크게 줄어듭니다. 스프링 AI에서는 .advisors()에 AdvisorParams.ENABLE_NATIVE_STRUCTURED_OUTPUT을 넘기면 켜지고, entity() 호출은 그대로 둡니다. 그러면 프레임워크가 대상 클래스로 스키마를 만들고, 사용 중인 모델이 네이티브 출력을 지원하는지 확인한 뒤, 지원하면 제공자 규격에 맞는 파라미터에 스키마를 담아 보냅니다. 이때 프롬프트 텍스트의 형식 지침은 빠집니다.
모든 요청에 기본으로 적용하려면 defaultAdvisors()에 등록하면 됩니다. 다만 모델 지원은 제각각입니다. AdvisorParams의 자바독은 사고(thinking) 모드가 있는 올라마 모델이 JSON 대신 일반 텍스트로 답할 수 있고, 오픈AI의 구조화 출력 API는 최상위 배열 스키마를 받지 않아 List<T> 대상이 실패한다고 적습니다. 그래서 책은 일반 대화용 chatClient와 네이티브 모드를 고정한 structuredChatClient를 따로 빈으로 등록하고 용도에 맞게 골라 쓰는 구성을 권합니다.
스키마를 싣는 파라미터는 제공자마다 다르지만(오픈AI는 response_format, 올라마는 format) 스프링 AI가 그 차이를 맞춰 주므로 애플리케이션 코드는 같습니다. 책에 따르면 올라마 0.5 이상에서 돌리는 로컬 모델, 오픈AI GPT-4o 이후 모델, Gemini 1.5 Pro 이후 모델, 앤트로픽 클로드 Sonnet 4.6 이후 모델이 네이티브 방식을 지원합니다. 네이티브 모드를 켜지 않으면 ChatClient는 앞에서 본 프롬프트 방식으로 동작하고, 네이티브 모드가 없는 구형 모델이라면 빌트인 JSON 모드라도 켜서 문법 오류만큼은 막는 것이 차선책입니다.
예제로 보는 구조화한 출력
예제 저장소의 2장 Step 3은 요리 이름을 입력받아 모델의 답을 Recipe 레코드로 받고 표 모양으로 출력합니다. 먼저 받을 타입과 클라이언트를 준비합니다.
@Component
@ConditionalOnProperty(prefix = "spring.ai.cli", name = "step", havingValue = "ch2-step3")
class Ch2Step3_StructuredOutput implements CommandLineRunner {

    record Recipe(
            String dishName,        // 요리 이름
            int cookingMinutes,     // 조리 시간(분)
            String mainIngredient   // 대표 재료
    ) {}

    private final ChatClient chatClient;

    Ch2Step3_StructuredOutput(ChatClient.Builder builder) {
        this.chatClient = builder.build();
    }
Recipe는 요리 이름, 조리 시간(분), 대표 재료로 이뤄진 단순한 레코드입니다. @ConditionalOnProperty는 spring.ai.cli.step 값이 ch2-step3일 때만 이 러너를 빈으로 등록합니다.
    @Override
    public void run(String... args) {
        System.out.println("=== [Ch2] Step3: 구조화한 출력 (Recipe, call + entity) ===");
        System.out.println("요리 이름을 입력하세요. 종료: /exit\n");

        try (Scanner scanner = new Scanner(System.in)) {
            while (true) {
                System.out.print("요리명 > ");
                String input = scanner.nextLine();
                if ("/exit".equalsIgnoreCase(input.trim())) break;

                Recipe recipe = chatClient.prompt()
                        .user("'" + input + "' 요리의 정보를 알려줘. 조리 시간(분)과 대표 재료를 알려줘.")
                        .call()
                        // 네이티브 구조화 출력: JSON 스키마를 Ollama 의 format 옵션으로 전달해 응답을 스키마에 맞게 강제
                        .entity(Recipe.class, spec -> spec.useProviderStructuredOutput().validateSchema());

                printRecipe(recipe);
            }
        }
    }
핵심은 entity() 한 줄입니다. useProviderStructuredOutput()은 이 호출에 네이티브 구조화한 출력을 켭니다. 앞 절의 AdvisorParams.ENABLE_NATIVE_STRUCTURED_OUTPUT을 어드바이저 파라미터로 넘기는 대신 entity() 옵션으로 지정한 형태입니다. 스프링 AI는 Recipe로 만든 JSON 스키마를 올라마 요청의 format 파라미터에 담아 보내고, 돌아온 JSON을 Jackson으로 역직렬화해 Recipe 객체를 돌려줍니다. 함께 붙인 validateSchema()는 응답이 형식에 맞지 않으면 자동으로 다시 시도하게 합니다.
2장 CLI 챗봇에서 이 단계만 .stream() 대신 .call()을 씁니다. 완성된 JSON이 있어야 객체로 바꿀 수 있고, entity() 메서드도 call()이 돌려주는 CallResponseSpec에만 정의되어 있기 때문입니다. 책에 실린 실행 예에서는 "김치찌개"를 입력하면 조리 시간 35분, 대표 재료 김치가 담긴 Recipe가 표로 출력됩니다.
4-티어 아키텍처에서의 위치
구조화한 출력은 T2 오케스트레이션 계층에서 모델의 답과 애플리케이션 코드 사이의 형식을 맞추는 부품입니다. 모델의 결과가 필드와 타입을 갖춘 객체로 들어와야 비즈니스 로직이 그 값을 바로 쓸 수 있습니다. 토큰과 컨텍스트 윈도우는 같은 계층에서 모델에 무엇을 얼마나 넣을지 정하는 제약 조건입니다. 다음 글 대화 메모리와 어드바이저 체인: 스프링 AI의 코어에서는 이전 대화를 기억하는 대화 메모리와, 메모리 같은 부가 기능을 요청 흐름에 끼워 넣는 어드바이저 체인을 다룹니다.
책에서 더 다루는 내용
책 2.5~2.6절
- 오픈AI 토크나이저 화면으로 토큰 분할을 확인하는 예시
- 코드 리뷰 에이전트용 하이브리드 프롬프트 전문과 부분마다 언어를 고른 이유
BeanOutputConverter형식 지침 템플릿 원문과 JSON 스키마 생성 과정- 변환기별 반환 타입, 용도, 동작 방식을 정리한 비교표와 사용 코드
- XML 변환기와 파이프 구분 목록 변환기를 직접 구현한 전체 코드
- 제공자별 빌트인 JSON 모드와 네이티브 구조화한 출력 설정 비교표, 용도별
ChatClient빈 구성 코드
참고 자료
- OpenAI Tokenizer: 텍스트의 토큰 분할을 확인하는 오픈AI 도구
- Do Multilingual LLMs Think in English?: Schut 외(2025), 다국어 LLM이 영어 중심 표현 공간을 활용하는지 분석한 논문
- Structured Output API: 스프링 AI 레퍼런스의 구조화한 출력 문서