MCP 기본과 스프링 AI MCP 클라이언트
앞 글까지 다룬 툴은 모두 애플리케이션 안에서 실행됐습니다. 그런데 모델에 툴을 알리는 형식은 제공자마다 다릅니다. 오픈AI는 "type": "function", 앤트로픽은 input_schema, 구글 제미나이는 function_declarations를 씁니다. 모델을 바꾸거나 여러 모델을 지원하려면 툴 정의를 다시 써야 합니다.
앤트로픽이 2024년 11월에 공개한 MCP(Model Context Protocol)는 AI 애플리케이션과 외부 시스템을 잇는 방식을 공개 프로토콜 하나로 맞춥니다. AI 애플리케이션에는 MCP 클라이언트를, 외부 시스템에는 MCP 서버를 두고 둘이 표준 메시지로 통신합니다. 제각각이던 충전 단자를 하나로 모은 것에 비유해 'AI를 위한 USB-C 포트'라고도 부릅니다.
5장의 첫 글인 이 글은 MCP의 구조와 프리미티브, 전송 방식을 정리한 뒤, 스프링 AI MCP 클라이언트를 설정하고 확장하는 방법을 chapter5 예제 코드로 확인합니다.
호스트, 클라이언트, 서버
MCP의 참여자는 세 역할로 나뉩니다.
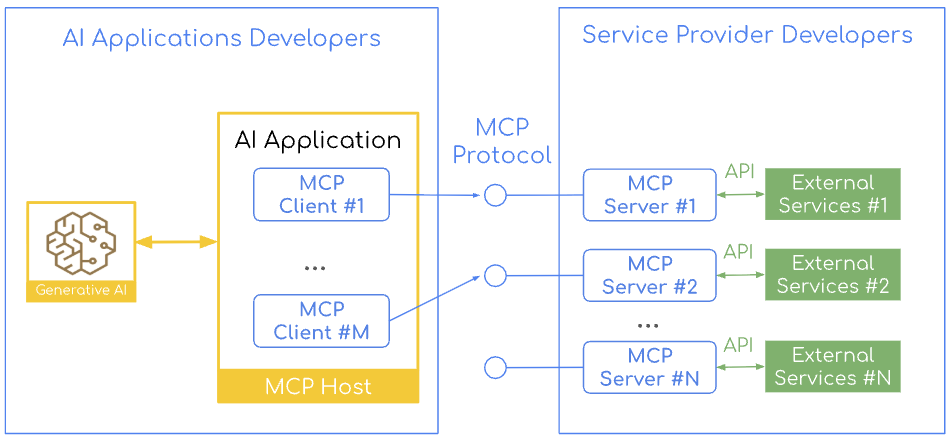
- MCP 호스트: 클로드 데스크톱이나 비주얼 스튜디오 코드 같은 AI 애플리케이션입니다. 연결할 외부 시스템마다 MCP 클라이언트를 만들고 조율합니다.
- MCP 클라이언트: 호스트 안에서 서버 하나와 전용 연결을 맺습니다. 서버가 셋이면 클라이언트도 셋이라 연결마다 컨텍스트와 권한이 분리됩니다.
- MCP 서버: 데이터나 툴을 제공하는 독립 프로그램입니다. 여러 클라이언트와 동시에 연결하고(1:N) 연결마다 세션을 따로 둡니다.
서버마다 프로세스가 분리돼 있어 깃허브 서버가 손상돼도 데이터베이스 서버의 권한에는 영향을 주기 어렵습니다. 서버에는 맡은 시스템에 필요한 최소 권한만 주고, 호스트는 어느 서버가 어떤 툴을 가졌는지 파악해 요청을 맞는 클라이언트로 보냅니다. MCP는 세션을 유지하는 프로토콜이므로 서버는 클라이언트별 세션을 격리하고, 클라이언트는 타임아웃, 오류 처리, 재연결을 갖춥니다. 역할이 이렇게 나뉜 덕분에 서버는 표준대로 한 번 만들면 어느 호스트에서나 쓰이고, 호스트는 서버의 구현 언어와 상관없이 같은 클라이언트 구현으로 연결합니다.
주고받는 기능 단위, 프리미티브
클라이언트와 서버가 주고받는 기능 단위를 프리미티브라고 합니다. 누가 기능을 열고 누가 부르느냐에 따라 세 묶음으로 나뉩니다.
| 방향 | 프리미티브 | 쓰임 |
|---|---|---|
| 서버 제공, 클라이언트 호출 | 툴, 리소스, 프롬프트, 자동 완성 | 작업 실행, 읽기 전용 컨텍스트, 재사용 템플릿, 인자 추천 |
| 클라이언트 제공, 서버 호출 | 샘플링, 추가 정보 요청(elicitation), 경계(roots) | 클라이언트의 LLM 빌려 쓰기, 사용자 입력과 승인, 접근 범위 지정 |
| 양방향 | 알림, 진행률, 핑 | 목록 변경 통지, 진행 상황, 연결 확인 |
샘플링 덕분에 서버는 자체 API 키 없이 클라이언트의 모델을 씁니다.
자바 MCP 스택과 클라이언트의 역할
MCP 명세는 프로토콜을 데이터 계층과 전송 계층으로 나누고, 자바 MCP SDK는 이를 클라이언트와 서버에 같은 모양의 스택으로 구현했습니다.
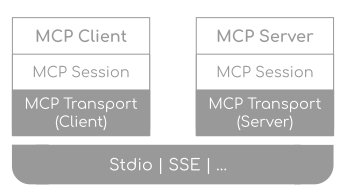
- 클라이언트와 서버 레이어(데이터 계층): 프리미티브를 다룹니다. 클라이언트는 모델의 결정에 따라 툴 실행이나 리소스 조회를 요청하고, 서버는 프리미티브를 공개하고 실행합니다.
- 세션 레이어(데이터 계층): JSON-RPC 2.0 메시지의 라우팅, 요청과 응답 ID 매칭, 오류 처리를 맡습니다.
McpClientSession은initialize요청으로 버전과 기능을 협상하고, 서버가 응답하면initialized알림으로 준비가 끝났음을 알립니다.McpServerSession은 초기화 요청을 검증하고 여러 클라이언트의 세션을 따로 관리합니다. - 트랜스포트 레이어(전송 계층):
McpTransport인터페이스로 추상화돼 있고, 메시지를 직렬화해 실제 채널로 주고받습니다. 클라이언트 쪽은 원격 URL에 접속할지 로컬 프로세스를 띄울지 정하고, 서버 쪽은 엔드포인트를 열고 기다립니다.
전송 프로토콜은 세 가지입니다. STDIO는 같은 장비의 두 프로세스를 표준 입출력으로 이어 네트워크를 거치지 않습니다. Streamable HTTP는 원격용으로, 엔드포인트 하나가 POST와 GET을 받고 필요하면 SSE로 스트리밍합니다. HTTP with SSE는 2024-11-05 명세에서 쓰던 원격 방식입니다. 2025-03-26 명세부터 Streamable HTTP로 바뀌었지만 SDK들은 하위 호환을 위해 계속 지원합니다. 계층이 나뉘어 있어 전송을 바꿔도 위쪽 로직은 그대로입니다.
이 구조에서 모델은 서버와 직접 통신하지 않고, 서버마다 하나씩 붙은 자바 MCP 클라이언트가 연결을 맡습니다. 클라이언트는 프로토콜 버전을 협상하고, 툴과 리소스, 프롬프트 목록을 조회하고, 요청 결과를 애플리케이션에 넘깁니다. STDIO 전송이면 서버를 자식 프로세스로 띄우는 일도 클라이언트가 합니다. 원격이든 로컬이든 같은 방식으로 다루므로 툴의 위치보다 기능에 집중할 수 있습니다.
직접 툴 호출과 MCP 툴 호출
두 방식 모두 모델에 툴 목록과 JSON 스키마를 주고 모델이 고르게 합니다. 다른 점은 툴 구현의 위치와 호출 방식입니다.
직접 툴 호출은 툴이 애플리케이션과 같은 JVM에 있어 빠르고, 스프링의 트랜잭션이나 사용자 세션도 바로 씁니다. 하지만 툴도 자바로 써야 하고, 다른 팀이 쓰려면 다시 구현해야 하며, 툴 하나에 부하가 몰려도 애플리케이션 전체를 늘려야 합니다.
MCP 툴 호출은 툴을 독립된 서버로 떼어 냅니다. 모델이 툴을 요청하면 클라이언트가 JSON-RPC로 서버에 실행을 맡기고 결과를 모델에 돌려줍니다. 파이썬 분석 툴도 로컬 함수처럼 부르고 여러 시스템이 서버를 공유하지만, 서버 운영과 감시, 지연과 네트워크 장애 대비라는 비용이 따릅니다.
이 선택은 모놀리식에서 마이크로서비스로 옮겨 가던 고민과 닮았습니다. 책에서는 직접 툴 호출로 시작하고 툴 공유, 다른 언어 활용, 권한 분리가 필요해질 때 MCP 서버로 떼어 내기를 권합니다. 스프링 AI는 두 방식을 모두 지원하므로 기존 툴 코드도 의존성과 설정을 더해 MCP 서버로 노출할 수 있습니다.
MCP 클라이언트 부트 스타터와 공통 설정
스프링 AI의 MCP 클라이언트 부트 스타터는 JDK HttpClient 기반의 spring-ai-starter-mcp-client와 웹플럭스 기반의 spring-ai-starter-mcp-client-webflux 두 가지입니다. 둘은 전송 구현만 다르고 STDIO, Streamable HTTP, 동기와 비동기를 똑같이 지원합니다. 일반적인 스프링 MVC 환경이면 기본 스타터를, 전 구간이 반응형이면 웹플럭스 스타터를 고릅니다. chapter5는 기본 스타터를 쓰고, 설정은 모두 spring.ai.mcp.client 아래에 둡니다.
    mcp:
      client:
        enabled: true
        name: chapter5-mcp-client
        version: 0.1.0
        type: SYNC
        initialized: true
        request-timeout: 30s
        toolcallback:
          enabled: true
        streamable-http:
          connections:
            rag:
              url: http://localhost:8085
              endpoint: /mcp
예제는 기본값인 항목도 적었고, name, version, request-timeout(기본 20초를 30초로)만 바꿨습니다. 동작을 크게 좌우하는 속성은 셋입니다.
type:SYNC(기본값) 또는ASYNC입니다. 스타터가 전송 구현을 정한다면 이 값은 클라이언트가 응답을 기다릴지 반응형 타입으로 받을지를 정합니다. 애플리케이션 전체에 한 가지로 적용되고, 어떤 애너테이션 핸들러가 등록될지도 이 값에 달려 있습니다.initialized:true(기본값)면 빈을 만들 때 핸드셰이크를 하므로 서버가 꺼져 있으면 기동이 실패합니다.false면 기동은 되지만 필요한 시점에initialize()를 직접 불러야 합니다.toolcallback.enabled:true(기본값)면 서버 툴을ToolCallback으로 모은SyncMcpToolCallbackProvider(비동기는AsyncMcpToolCallbackProvider) 빈이 등록됩니다. 끄면 이 빈이 생기지 않으므로 클라이언트로 툴을 직접 호출해야 합니다.
STDIO와 원격 서버 연결
연결은 전송 방식별 접두사 아래에 이름을 키로 선언합니다. 이 이름은 커스터마이저와 애너테이션에서 대상 서버를 가리키는 식별자로도 쓰입니다.
STDIO는 stdio.connections.<이름>에 command, args, env를 적거나 servers-configuration으로 클로드 데스크톱 형식의 JSON 파일을 지정합니다. 윈도우의 npx는 배치 파일이라 ProcessBuilder가 바로 실행하지 못하므로 cmd.exe /c로 감쌉니다. 운영체제가 섞인 팀이면 프로파일별로 다른 JSON 파일을 읽게 합니다.
원격 서버는 Streamable HTTP라면 streamable-http.connections.<이름>에 url과 endpoint(기본값 /mcp)를, HTTP with SSE라면 sse.connections.<이름>에 url과 sse-endpoint(기본값 /sse)를 씁니다. url에는 스킴, 호스트, 포트까지만 두고, 경로와 쿼리 파라미터는 /로 시작하는 엔드포인트 값에 넣습니다. 연결할 때 404가 나면 이 분리부터 점검합니다.
원격 서버 인증을 위해 연결 설정 아래에 headers 필드를 두자는 논의(이슈 #3948, PR #3949)가 있었지만 스프링 AI 팀은 설정 범위를 넓히지 않기로 했습니다. 토큰은 수명이 짧아 주기적으로 바뀌고, 요청마다 다른 사용자 권한을 실어야 할 수 있으며, 서버마다 인증 방식도 다르기 때문입니다. McpSyncHttpClientRequestCustomizer 빈으로 고정 헤더를 넣을 수는 있지만 모든 서버에 같은 토큰이 나가므로 로컬 검증용에 가깝습니다. OAuth2 기반 보안은 MCP 보안 글에서 다룹니다.
자동 구성된 클라이언트와 툴 콜백 공급자
자동 구성된 클라이언트는 type에 맞춰 List<McpSyncClient>나 List<McpAsyncClient>로, 모든 서버의 툴을 모은 공급자는 SyncMcpToolCallbackProvider나 AsyncMcpToolCallbackProvider로 주입됩니다. 동기 설정인 예제의 McpClientCatalogService는 List<McpSyncClient>와 SyncMcpToolCallbackProvider를 생성자로 받습니다.
@Service
@Profile("!server")
public class McpClientCatalogService {

    private final List<McpSyncClient> mcpClients;
    private final SyncMcpToolCallbackProvider toolCallbackProvider;

    public McpClientCatalogService(
            List<McpSyncClient> mcpClients,
            SyncMcpToolCallbackProvider toolCallbackProvider) {
        this.mcpClients = mcpClients;
        this.toolCallbackProvider = toolCallbackProvider;
    }

    public String serverSummary() {
        McpSyncClient client = primaryClient();
        McpSchema.Implementation serverInfo = client.getServerInfo();
        McpSchema.ServerCapabilities capabilities = client.getServerCapabilities();
        return """
                Server: %s %s
                Instructions: %s
                Capabilities: %s
                """.formatted(
                serverInfo.name(),
                serverInfo.version(),
                client.getServerInstructions(),
                capabilities);
    }

    public String listTools() {
        return primaryClient().listTools().tools().stream()
                .map(tool -> "- %s: %s".formatted(tool.name(), tool.description()))
                .reduce((left, right) -> left + "\n" + right)
                .orElse("노출된 MCP 툴이 없습니다.");
    }
serverSummary()는 초기화 때 받은 서버 정보와 기능 목록을, listTools()는 툴 목록을 가져옵니다. Client Step 1(Ch5Step1_McpDiscovery)은 여기에 리소스와 프롬프트 목록을 더해 출력하고, Step 2(Ch5Step2_McpPrimitiveCalls)는 같은 서비스로 callTool, readResource, getPrompt, completeCompletion을 불러 툴 밖의 프리미티브도 써 봅니다.
공급자가 내놓는 콜백은 스프링 AI의 일반 ToolCallback입니다. Step 3은 그중 rag_search_documents를 꺼내 모델 없이 직접 실행합니다.
    @Override
    public void run(String... args) {
        System.out.println("=== [Ch5] Client Step3: SyncMcpToolCallbackProvider ===");
        System.out.println(catalogService.listToolCallbacks());

        ToolCallback callback = catalogService.toolCallback("rag_search_documents");
        String result = callback.call("""
                {"query": "개인 정보가 포함된 문서는 어떻게 처리해야 하나요?", "topK": 3, "category": "tech_docs"}
                """, new ToolContext(Map.of(
                "userId", "step3-user",
                "conversationId", "step3-conversation",
                "clientSession", "ch5-client-step3"
        )));

        System.out.println("\n[Direct ToolCallback Result]");
        System.out.println(result);
    }
JSON 인자와 함께 넘긴 ToolContext는 MCP 툴 호출의 메타데이터로 바뀌어 서버에 전달됩니다. 모델에 연결할 때는 getToolCallbacks() 결과를 ChatClient의 툴로 등록합니다. 최종 CLI의 McpEnabledChatService는 이를 defaultTools()로 넘깁니다.
커스터마이저와 툴 정책
서버도 클라이언트에 샘플링이나 추가 정보를 요청하고 로그와 진행률을 보냅니다. 스프링 AI는 이런 처리와 툴 노출 정책을 확장 지점으로 열어 두고, 구현 빈이 있으면 자동 구성에 반영합니다. 예제의 Chapter5McpClientConfiguration은 네 가지를 모두 빈으로 등록합니다.
    @Bean
    McpClientCustomizer<McpClient.SyncSpec> chapter5McpSyncClientCustomizer() {
        return (serverConfigurationName, spec) -> spec
                .requestTimeout(Duration.ofSeconds(30))
                .roots(new McpSchema.Root(workspaceRoot(), "chapter5 workspace"))
                .progressConsumer(progress -> logger.info("[{}] MCP progress: {} / {} {}",
                        serverConfigurationName,
                        progress.progress(),
                        progress.total(),
                        progress.message()))
                .loggingConsumer(logMessage -> logger.info("[{}] MCP log [{}] {}",
                        serverConfigurationName,
                        logMessage.level(),
                        logMessage.data()));
    }

    @Bean
    McpToolFilter chapter5McpToolFilter() {
        return (connectionInfo, tool) -> tool.name().startsWith("rag_")
                && (tool.description() == null || !tool.description().contains("experimental"));
    }

    @Bean
    McpToolNamePrefixGenerator chapter5McpToolNamePrefixGenerator() {
        return McpToolNamePrefixGenerator.noPrefix();
    }

    @Bean
    ToolContextToMcpMetaConverter chapter5ToolContextToMcpMetaConverter() {
        return this::toMcpMeta;
    }
- 클라이언트 동작:
McpClientCustomizer<McpClient.SyncSpec>빈(비동기는McpClientCustomizer<McpClient.AsyncSpec>)이 연결 이름과 스펙을 받아 타임아웃, 경계(roots), 진행률과 로그 소비자를 등록합니다.sampling,elicitation핸들러도 같은 스펙에 걸고, 연결 이름으로 분기하면 서버마다 정책을 달리할 수 있습니다. - 툴 필터:
McpToolFilter로 노출할 툴을 고릅니다. 예제는rag_로 시작하고 설명에experimental이 없는 툴만 남기며, 필터 빈은 하나만 둘 수 있습니다. - 툴 이름:
McpToolNamePrefixGenerator가 서버 간 이름 충돌을 막습니다. 기본 구현인DefaultMcpToolNamePrefixGenerator는 겹친 이름에alt_1_같은 접두사를 붙이고, 예제는 연결이 하나라noPrefix()를 씁니다.noPrefix()를 다중 서버에서 쓰다가 이름이 겹치면IllegalStateException이 발생합니다. - 메타데이터:
ToolContextToMcpMetaConverter가 툴 실행 문맥인ToolContext의 값을 MCP 툴 호출의 메타데이터로 옮깁니다. 기본값인ToolContextToMcpMetaConverter.defaultConverter()는 값이 있는 항목을 모두 넘기므로, 예제의toMcpMeta()는userId,conversationId,clientSession,progressToken만 통과시킵니다.
Client Step 4(Ch5Step4_McpClientPolicy)는 rawSecret을 섞은 ToolContext를 이 변환기로 바꿔 출력합니다. 허용 목록에 없는 rawSecret은 결과에 담기지 않습니다.
MCP 클라이언트 애너테이션
서버의 요청과 알림 처리는 애너테이션으로 선언할 수도 있습니다. 클라이언트 스타터에 spring-ai-mcp-annotations가 들어 있어, 스프링 빈의 메서드에 붙이면 스캐너(annotation-scanner.enabled, 기본값 true)가 등록합니다.
| 애너테이션 | 처리 대상 | 반환형(동기 / 비동기) |
|---|---|---|
@McpSampling |
샘플링 요청 | CreateMessageResult / Mono<CreateMessageResult> |
@McpElicitation |
추가 정보 요청 | ElicitResult / Mono<ElicitResult> |
@McpLogging, @McpProgress, @McpToolListChanged 등 |
로그, 진행률, 목록 변경 알림 | void / void 또는 Mono<Void> |
대상 서버는 @McpLogging(clients = "rag")처럼 clients 속성에 연결 이름으로 지정합니다. 이 속성은 문자열 배열이라 여러 연결을 한 메서드에 묶을 수도 있습니다. 한 클래스에 동기와 비동기 메서드를 함께 두면 type 설정에 맞는 반환형의 메서드만 등록됩니다.
다만 애너테이션으로는 경계(roots)를 지정할 수 없고, 연결 이름이 코드에 고정돼 런타임에 대상을 바꾸지 못합니다. 또 자동 구성은 애너테이션 핸들러를 등록한 다음 커스터마이저를 실행하므로 샘플링이나 추가 정보 요청처럼 하나만 두는 핸들러 슬롯을 양쪽에서 설정하면 커스터마이저가 덮어씁니다. 서버가 정해져 있으면 애너테이션이, 연결이 자주 바뀌면 커스터마이저가 어울리며, 한 팀에서는 한 방식으로 통일하는 편이 낫습니다.
4-티어 아키텍처에서의 위치
4-티어 아키텍처에서 T2 오케스트레이션과 T3 능력은 능력 호출 표준 인터페이스를 사이에 두고 만납니다. 책은 이 인터페이스에 MCP를 씁니다. MCP 클라이언트는 원격 T3 능력을 ToolCallback으로 바꿔 T2의 툴 루프가 로컬 툴과 같은 방식으로 부르게 합니다. 같은 프로세스에서 실행할 능력은 로컬 툴로, 따로 운영할 능력은 MCP 서버로 나누면 능력을 늘려도 오케스트레이션 코드는 그대로입니다. 경계 건너편의 MCP 서버는 다음 글 스프링 AI로 MCP 서버 만들기: 부트 스타터부터 애너테이션까지에서 만듭니다.
책에서 더 다루는 내용
책 5.1~5.2절
- MCP 프리미티브 11가지의 노출 방향과 설명
- 직접 툴 호출과 MCP 사용 아키텍처 비교표
- 공통 설정 속성표와 두 스타터의 권장 환경
- STDIO JSON 설정, 윈도우 경로 규칙, 운영체제별 프로파일 예제
- 원격 URL 분리 지침, 서버별 커스텀 헤더 라우팅, 커스터마이저와 애너테이션 전체 예제
참고 자료
- Model Context Protocol: 공식 사이트, 명세와 언어별 SDK
- Transports (2024-11-05): HTTP with SSE 정의
- Transports (2025-03-26): Streamable HTTP 도입
- MCP Java SDK Overview: 자바 MCP 클라이언트와 서버 구조
- Connect Your AI to Everything: Spring AI's MCP Boot Starters: 스프링 AI MCP 부트 스타터 소개
- Support custom HTTP headers for MCP transport (이슈 #3948, PR #3949): 연결별
headers설정 논의